Requisitos para entrega do ambiente Citsmart
Objetivo
Este documento tem como objetivo descrever a arquitetura de referência para a implantação da plataforma Citsmart On-Premise, contemplando organização em camadas, estrutura física e lógica, mecanismos de automação, segurança e infraestrutura necessária para operação em ambiente do cliente.
Visão Geral das Camadas
Camada Web
- Kong – API Gateway: segurança, roteamento e rate limiting
- NGINX – Ingress controller do cluster
- Keycloak – Autenticação centralizada: OAuth2, OIDC, SAML
- Rancher/OKD – Orquestrador do cluster
- Edge Runtime – executor de código JavaScript/TypeScript
Camada de Aplicação
- Aplicações: Aplicações do Citsmart implantadas como microserviços.
- Kafka + Kafka Connect: fila de eventos e conectores externos.
- Redis: caching e controle de sessão.
- Elasticsearch: logs, buscas e indexação distribuída.
Camada de Dados
- PostgreSQL 13+: banco de dados principal. (cluster principal e réplicas)
- MinIO: armazenamento de objetos compatível com S3.
- NFS: volumes persistentes para PVCs no Kubernetes.
- PgBouncer: gerenciamento do pool de conexões
Camada de Integração
- Apache NiFi: fluxo de dados, transformação e integração visual.
- Kafka Connect: conectividade com sistemas externos.
- Webhooks/REST APIs: consumo e entrega de eventos.
Camada de IA
- Tika: extração de conteúdo: PDFs, Docx, Imagens, planilha e apresentações
- Langchain: Framework modular para construir aplicações com LLMs
- Psycopg: Armazenamento de embeddings, cache de conversa e metadados estruturados
- gTTS: TTS, prototipagem funcional
- LangSmith: Debugging de chains, avaliação de qualidade e monitoramento
- PGVector: Extensão para vetores
✅ 1. Entrega de servidores para o Cluster
Necessário acesso Root aos servidores
Topologia do Ambiente
Sistema Operacional:
- AWS Linux RedHat
- On-premises - Rock Linux, Ubuntu, Linux Red Hat
- OKE – OCI Oracle Linux (baseado no RedHat)
Cluster Kubernetes
Hostname | CPU | RAM (GB) | HD | Tipo |
|---|---|---|---|---|
master1 | 8 | 8 | 100 GB | controlplane, etcd |
master2 | 8 | 8 | 100 GB | controlplane, etcd |
master3 | 8 | 8 | 100 GB | controlplane, etcd |
worker1 | 16 | 32 | 200 GB | worker |
worker2 | 16 | 32 | 200 GB | worker |
worker3 | 16 | 32 | 200 GB | worker |
worker4 | 16 | 32 | 200 GB | worker |
worker5 | 16 | 32 | 200 GB | worker |
Servidores Adjacentes
Hostname | CPU | RAM | HD | Função |
|---|---|---|---|---|
database1 | 32 | 64 | 100 GB LVM | PostgreSQL primário |
database2* | 32 | 64 | 100 GB LVM | PostgreSQL secundário (HA) |
haproxy1 | 2 | 4 | 40 GB | Load balancer (exposição 443) |
haproxy2* | 1 | 4 | 40 GB | Load balancer secundário (HA) |
nfs | 2 | 4 | 500 GiB – 1 TiB LVM | Volumes persistentes |
bastion | 2 | 4 | 40 GB | Runner + Ansible + provisionamento |
LLM free
Hostname | GPU | CPU | RAM (GB) | HD |
|---|---|---|---|---|
LLM node | NVidia A100.1 80GB de Ram | 14 | 236 | 50 |
Justificativa
Cluster Kubernetes
Ao implantar o Kubernetes, você obtém um cluster. Para mais informações detalhadas, pode ser consultado o documento oficial do Kubernetes no link https://kubernetes.io/ptbr/docs/concepts/overview/components/
Um cluster Kubernetes consiste em um conjunto de servidores de processamento, chamados nodes, que executam aplicações containerizadas. Todo cluster possui ao menos um servidor de processamento (worker node), porém se este falhar, todo o ambiente fica sem monitoramento das funcionalidades dos serviços e sem gerênciamento.
A descrição simples de cada tipo de nó pode ser da seguinte forma:
- Servidores Master, são responsáveis por manter o estado do cluster Kubernetes, agendam e criam Pods nos nodes Workers. Kubernetes usa o algoritmo de consenso RAFT para quorum. Para manter o quorum, você precisará de nodes mestres íntegros floor(n/2) 1. Praticamente isso significa:
- 1 nó mestre: você precisará de 1 nó mestre íntegro para o quorum, a perda do nó mestre deixará o cluster sem gerenciamento.
- 2 nodes mestres: você precisará de 2 nodes mestres íntegros para o quorum; a perda de qualquer um dos nodes mestres deixará o cluster sem gerenciamento.
- 3 nodes mestres: você precisará de 2 nodes mestres íntegros para o quórum, a perda de um dos nodes mestres pode ser compensada.
- 4 nodes mestres: você precisará de 3 nodes mestres íntegros para o quorum, a perda de um nos nodes mestres pode ser compensada. Uma configuração com 4 nodes mestres não tem vantagem sobre uma configuração de 3 nodes mestres.
- 5 nodes mestres: você precisará de 3 nodes mestres íntegros para o quorum, a perda de até dois nodes mestres pode ser compensada.
- 6 nodes mestres: você precisará de 4 nodes mestres íntegros para o quorum, a perda de até dois nodes mestres pode ser compensada. Nenhuma vantagem em comparação com 5 nodes mestres.
- 7 nodes mestres: você precisará de 4 nodes mestres íntegros para o quorum, a perda de até três nodes mestres pode ser compensada.
Esta é a razão pela qual é necessário utilizar um número ímpar de nodes master para o gerênciamento.
- Servidores workers são responsáveis por receberem as cargas de trabalho e executar os pods(contêineres). Um node apenas é possível executar cargas de trabalho, mas a perda deste, deixará o cluster sem lugar para os Pods. Foi selecionado a quantidade de 5 servidores worker para dividir a carga de trabalho, deixando os servidores com menos estresse nos recursos como CPU e RAM, a perda de um dos nodes worker será compensada pelos nodes restantes.
Servidores Adjacentes
- database- Será o servidor responsável pelo Banco de dados para todas as ferramentas do Citsmart X.
- haproxy - Um serviço de Proxy que pode ser utilizado em HA Alta Disponibilidade), a escolha de dois servidores será opcional, mas a perda dele, não pode ser compensada.
- bastion - Responsável por criar o cluster Kubernetes com o RKE, também será responsável pelo gerênciamento via linha de comando no cluster.
Diagrama do Ambiente
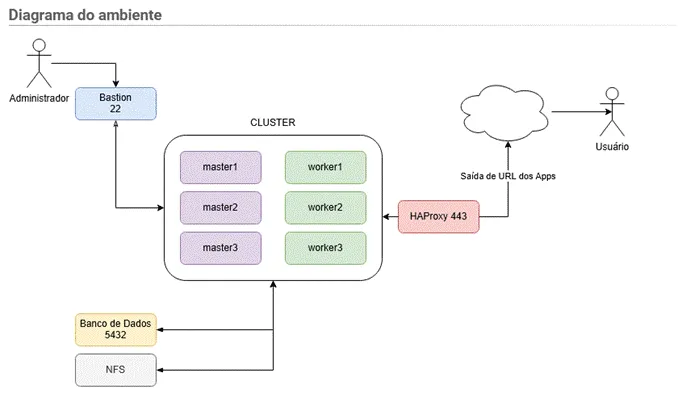
Diagrama acima contempla a utilização de 3 workers, que devem ser escalados de acordo com a necessidade da carga.
Como é feita a implantação
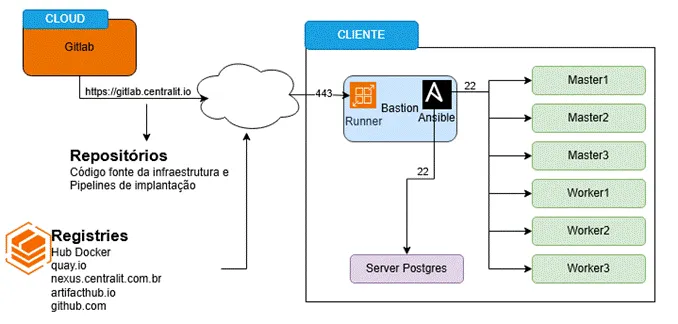
Diagrama acima contempla a utilização de 3 workers, que devem ser escalados de acordo com a necessidade da carga.
Observações:
- Bastion precisa chegar ao Banco de dados na porta 22 e 5432
- Bastion precisa chegar aos servidores do cluster na porta 22
- Bastion precisa resolver nomes(DNS) do ambiente.
- Todos os servidores precisam ter acesso root.
- HAProxy porta 443
- Banco de dados porta 5432 para o cluster.
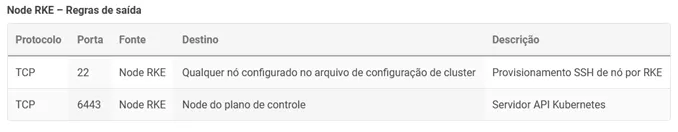
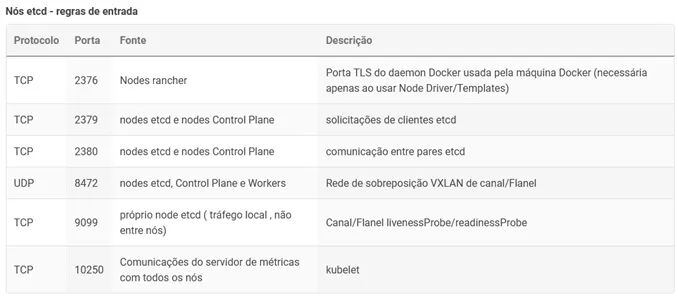
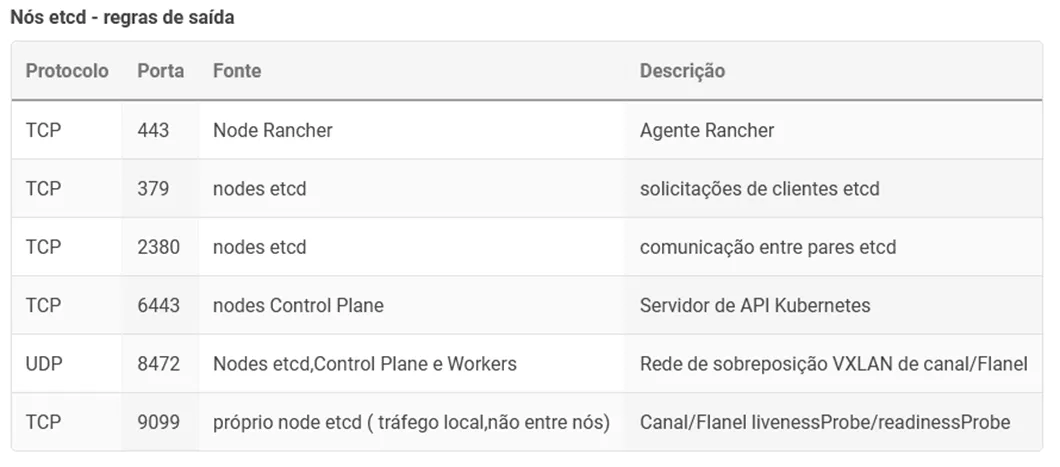
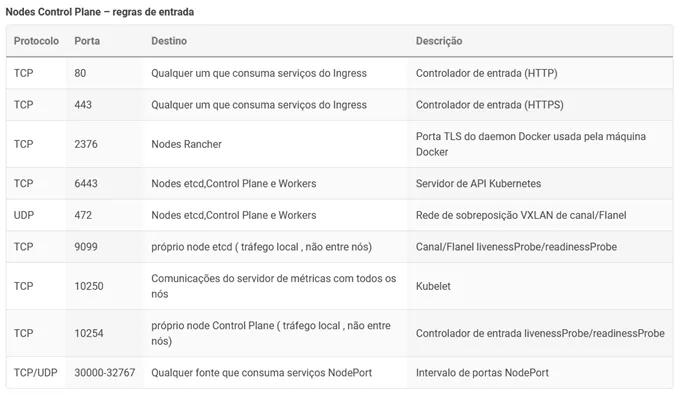
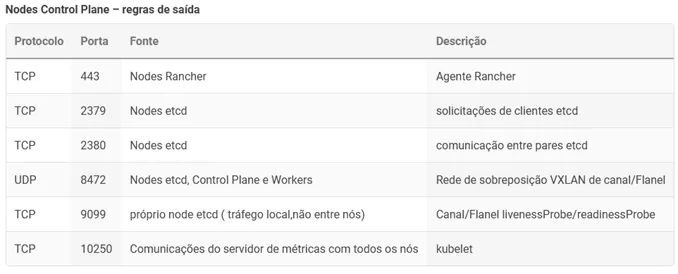
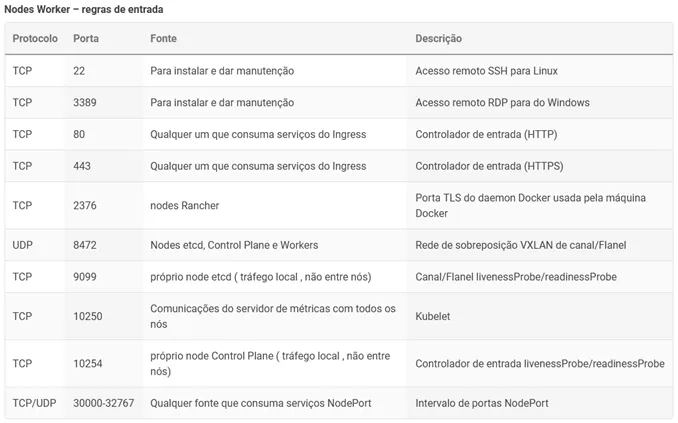
✅ 2. Regras de Firewall
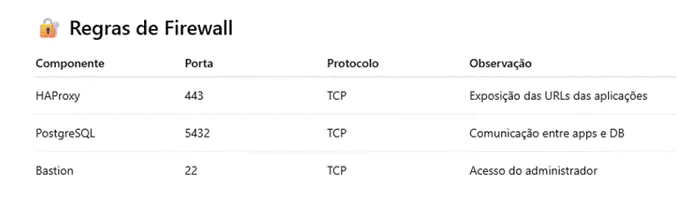
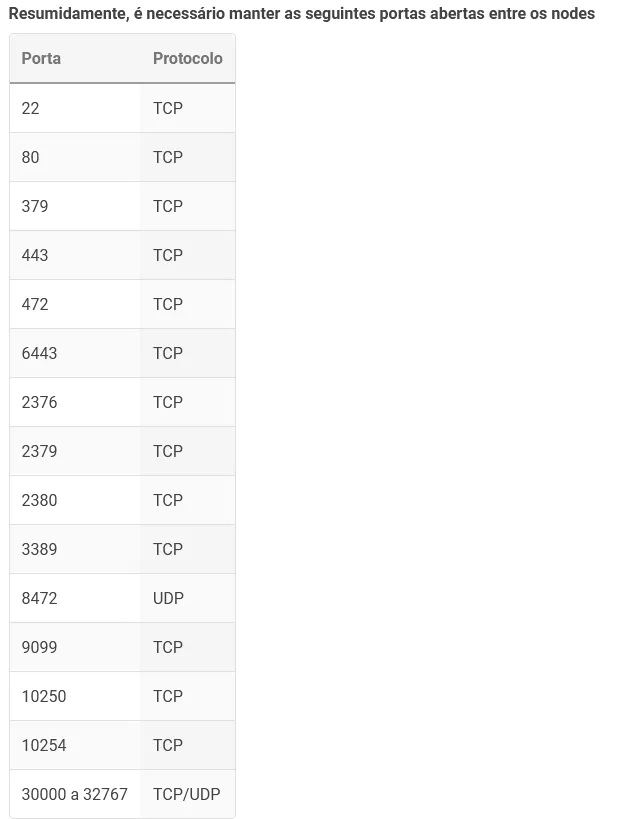
Justificativas
✅ 3. DNS
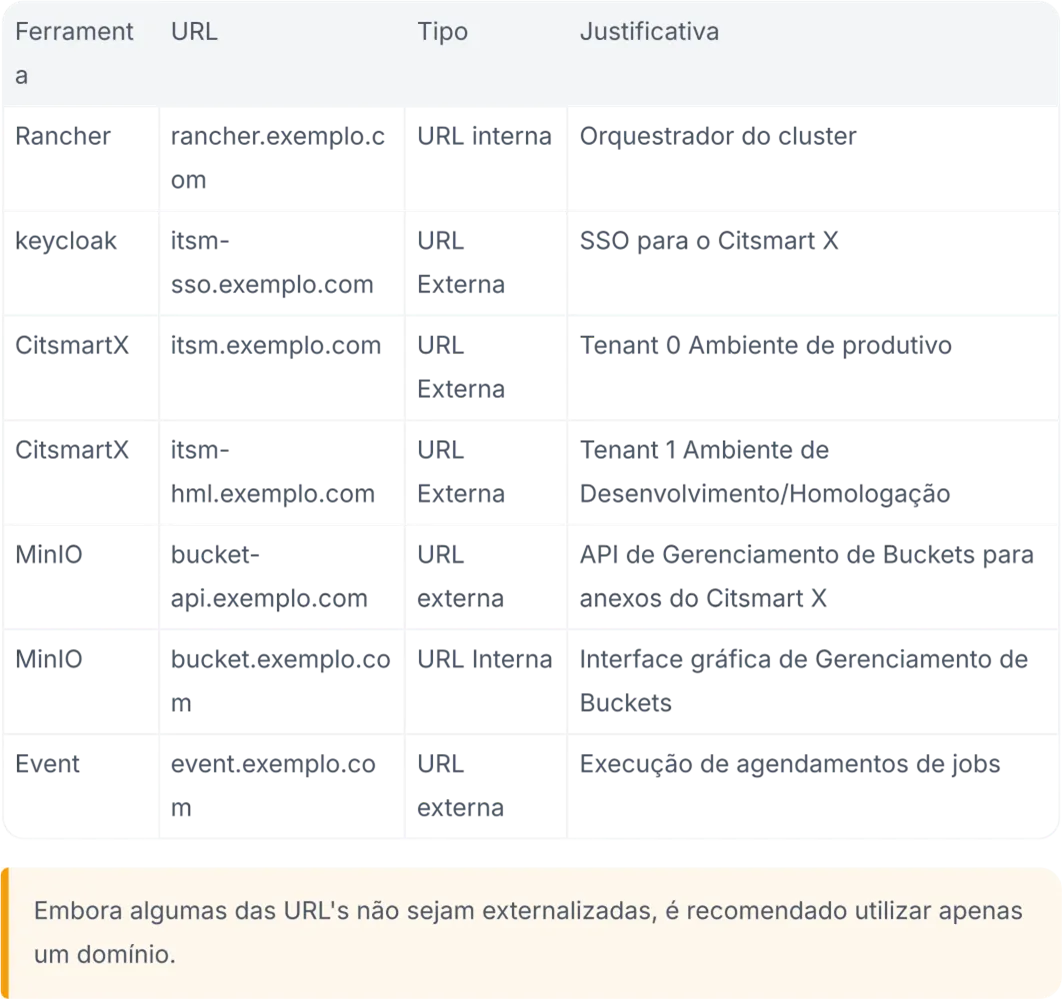
Após criar o servidor HAProxy na etapa 1, deve ser criadas as URL's abaixo e aponta-las para o servidor HAProxy caso for On-Premises ou IgressController caso for na Cloud.
✅ 4. Certificado
✅ 5. Acesso à internet
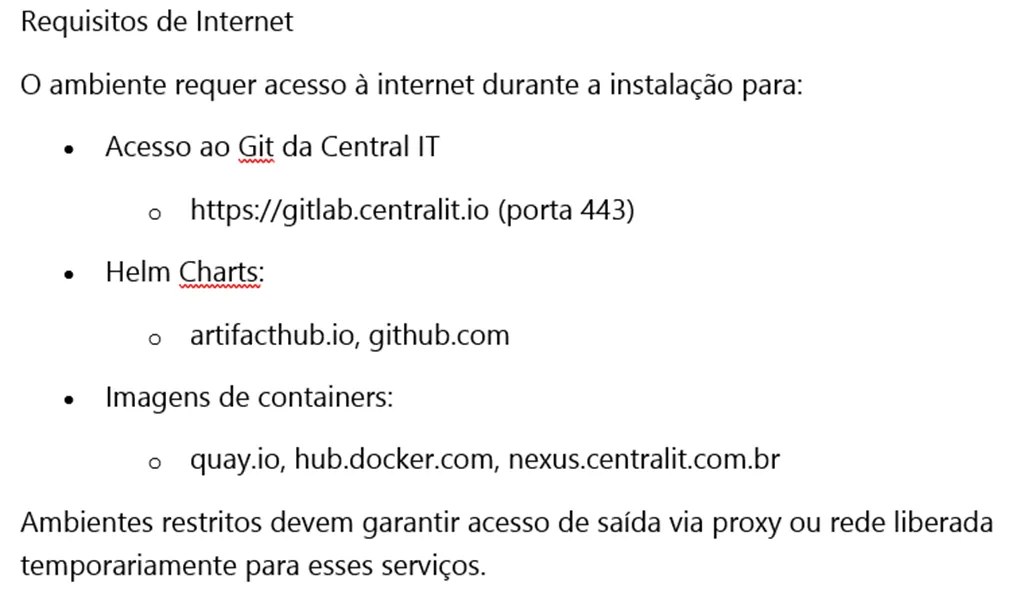
Acesso ao Git da empresa para automação de implantação.
- URL: https://gitlab.centralit.io
- Porta: 443
O processo de implantação faz uso de vários Helm Charts disponíveis em fontes como Artifact Hub e GitHub, Gitlab da Central IT.
Além disso, o processo depende de repositórios de imagens de contêiner, como Docker Hub, Quay.io e Nexus.
Em ambientes restritos, é essencial garantir acesso à internet durante a implantação para agilizar o processo.
Considerações Finais
Esta arquitetura oferece:
- Alta Disponibilidade: redundância de control plane, workers, bancos e proxy.
- Automação CI/CD: GitLab + Runner + Ansible + Helm.
- Escalabilidade Horizontal: adição de workers conforme necessidade.
- Flexibilidade On-Prem ou Cloud: adaptação de DNS e Load Balancer.
- Segurança: acesso restrito, certificados TLS e autenticação e autorização centralizada.
A seguir
Demais instalações:
Xventory
AIOPS
AURA