Low Code Web

Data: de publicação: 30/09/2026
Esta versão do Low Code Web corrige o travamento das execuções de FaaS das versões 1.18.1 a 1.18.3: os clientes HTTP compartilhados passam a ter limites de conexão e timeouts, com padrões calibrados e configuráveis por variáveis de ambiente. Nenhuma configuração é obrigatória, e voltar para a 1.18.3 traz o travamento de volta. Recomenda-se, porém, revisar heap, threads e cabeçalho HTTP dos pods: o risco de falta de memória dessa combinação existe desde a 0.7.4 e não muda nesta versão.
O que mudou
- Novas variáveis (padrões): FAASCLIENT_HTTP_MAXCONNPERROUTE=50, FAASCLIENT_HTTP_MAXCONNTOTAL=200, FAASCLIENT_HTTP_CONNECTTIMEOUTMS=5000, FAASCLIENT_HTTP_CONNECTIONREQUESTTIMEOUTMS=10000, FAASCLIENT_HTTP_READTIMEOUTMS=90000, FAASCLIENT_HTTP_KEEPALIVEMS=2000. Os APP_HTTPCLIENT_* (busca de tokens) têm os mesmos padrões, exceto APP_HTTPCLIENT_CONNECTIONREQUESTTIMEOUTMS=5000 e APP_HTTPCLIENT_READTIMEOUTMS=10000.
- Inalterados: SERVER_MAXHTTPHEADERSIZE (10MB) e SERVER_TOMCAT_THREADS_MAX (200).
- Função com mais de 90 s sem responder passa a falhar com Read timed out (e segue executando no node-faas).
Antes do deploy
- Funções com mais de 90 s sem resposta: configurar FAASCLIENT_HTTP_READTIMEOUTMS.
- Ingress (Kong 60 s, OpenShift Route 30 s, ingress-nginx 60 s): ajustar se funções acionadas pelo navegador puderem demorar mais.
- Liveness com timeoutSeconds: 5 e failureThreshold: 3; -XX:+ExitOnOutOfMemoryError em JAVA_TOOL_OPTIONS (não testada).
- Remover FAASCLIENT_DEFAULTCONNECTION_CONNECTIONTIMEOUT do ConfigMap, se existir.
- Conferir o heap máximo efetivo dos pods e aplicar a faixa abaixo.
Depois do deploy: linhas FaaS HTTP client: ... e REST HTTP client: ... no log sem WARN (a segunda só após uma busca de token); nenhum OutOfMemoryError; readiness abaixo de 1 s no pico.
Faixas de heap (distribuída = 10MB e 200 threads; ver Parametrização por faixa de heap)
- Abaixo de 4 GB (template de referência, cerca de 2,8 GiB): não é segura; falta memória a partir de cerca de 115 a 120 requisições simultâneas por pod. Use a recomendação de 4 GB com SERVER_MAXHTTPHEADERSIZE=64KB; ou suba o heap para 4 GB e, com 10MB, use 130 threads e mais réplicas.
- 4 GB: não é segura; falta memória a partir de cerca de 170 a 180. Normal: SERVER_MAXHTTPHEADERSIZE=64KB. Intenso: 64KB e SERVER_TOMCAT_THREADS_MAX=400. Com 10MB indispensável: 130 threads, junto com mais réplicas.
- 6 GB: no limite (segura só com base de até cerca de 0,4 GB); satura threads com cerca de 180 a 220. Normal: nada, se a base couber; senão 64KB. Intenso: 64KB e 400 threads.
- 8 GB: memória com folga; o limite são as threads (cerca de 180 a 220). Normal: nada. Intenso: 270 threads mantendo 10MB, ou 64KB e 400 threads.
- FaaS: padrões em qualquer faixa; FAASCLIENT_HTTP_MAXCONNPERROUTE=100 só em uso intenso, se a fórmula 1 pedir e o node-faas comportar. Capacidade extra vem de réplicas.
- Antes de reduzir o cabeçalho, procurar requisições acima de 64 KB; antes de passar de 200 threads, conferir max_connections do PostgreSQL e o pool de cada tenant.
Combinações perigosas
- 10MB com threads acima do teto da faixa (130 / 200 / 270), como 400: cerca de 9,6 GB só de buffers. Ao voltar de 64KB para 10MB, levar as threads ao teto da faixa antes ou no mesmo rollout; antes, considerar 128KB ou 256KB.
- Reduzir threads (ex.: 130) sem aumentar réplicas: colapso por falta de threads.
- FAASCLIENT_HTTP_MAXCONNPERROUTE acima de 100 (150 foi rejeitado) ou de metade das threads.
- FAASCLIENT_HTTP_CONNECTIONREQUESTTIMEOUTMS ≥ 15000 ou ≥ pool.connectionTimeout de algum tenant (erros de banco e de autenticação enganosos; tenant com pool.connectionTimeout abaixo de 10000 deve ir para pelo menos 15000); abaixo de 10000, perde execuções. 0 em timeout = sem limite.
Detalhes em Configuração, Ajuste de heap, threads e cabeçalho (todos os ambientes), Orientações para deploy e Validação.

🚀 Execuções de FaaS presas em fila após a versão 1.18.1
O que foi corrigido
- Limites de conexão nos dois clientes: 50 por destino e 200 no total.
- Timeouts para conectar, aguardar conexão livre e receber resposta, com padrões por cliente (mais curtos no genérico); ao estourar, a chamada falha e libera a conexão.
- Reutilização de conexões ociosas limitada a 2 s: o node-faas as fecha após 5 s, e reaproveitar uma conexão nesse instante fazia a execução falhar, sem repetição automática; o limite deixa 3 s de margem (KEEPALIVEMS em Parâmetros).
- Variáveis de ambiente com padrões (Configuração); nenhuma ação obrigatória.
- Log dos valores em uso na primeira utilização de cada cliente, com WARN para valor inválido ajustado ou proteção desligada (ex.: timeout 0).
- Substituição de FAASCLIENT_DEFAULTCONNECTION_CONNECTIONTIMEOUT (propriedade faas-client.default-connection.connection-timeout): só valeu da 1.6.0 à 1.8.6 (antes, aceita mas não lida; valor único em segundos, 90 se ausente, para os três timeouts); desde a 1.8.7 não é lida, e o FaaS ficou sem timeout. Substituída pelos FAASCLIENT_HTTP_* (os 90 s de resposta equivalem ao padrão antigo); continua ignorada e pode ser removida.
- Testes automatizados do limite antigo, da concorrência, da liberação por timeout, da reutilização de conexões e da leitura das variáveis.
Configuração
Os padrões já resolvem o travamento. Os parâmetros são variáveis de ambiente no ConfigMap do deployment do Low Code. Cada execução ocupa uma thread do Low Code durante todo o percurso: obtém conexão do pool (até MAXCONNPERROUTE; com todas ocupadas, espera na fila até CONNECTIONREQUESTTIMEOUTMS), conecta se precisar (até CONNECTTIMEOUTMS), aguarda a resposta (até READTIMEOUTMS) e devolve a conexão (descartada se ociosa além de KEEPALIVEMS). Quem espera na fila também ocupa thread (as mesmas de telas, APIs e health checks).
Parâmetros
Dois grupos com os mesmos seis parâmetros; nome = prefixo + parâmetro.
- FAASCLIENT_HTTP_*: chamadas ao node-faas (grupo deste card).
- APP_HTTPCLIENT_*: busca de tokens no Keycloak (recurso público com credenciais do projeto ou padrão; agente iniciado sem usuário autenticado). Raramente precisa de ajuste.
- Grafia sem separador: FAASCLIENT_HTTP_MAX_CONN_PER_ROUTE não é reconhecida, e o padrão vale sem aviso (mesma convenção de FAASCLIENT_DEFAULTCONNECTION_URL).
MAXCONNPERROUTE— padrão 50 nos dois grupos
- Máximo de execuções de FaaS simultâneas por pod; com 3 réplicas, até 150 no node-faas (mais os pods extras do rolling update). Ao atingir, não falha: entra na fila.
- No máximo cerca de metade de SERVER_TOMCAT_THREADS_MAX e nunca acima de 100 (150 rejeitado; fórmula 1): funções que chamam o Low Code precisam de uma segunda thread e, sem ela, só terminam por timeout.
- Aumentar só com execuções legítimas acima do limite e folga no node-faas (senão a fila só muda de lugar); diminuir para protegê-lo de picos.
MAXCONNTOTAL — padrão 200 nos dois grupos
- Teto somando destinos (só importa com vários, ex.: FaaS por tenant). Ao atingir, não falha: entra na fila. Deve ser ≥ MAXCONNPERROUTE, senão vira o limite (o log avisa). Não dividir pelas réplicas.
CONNECTTIMEOUTMS — padrão 5000 nos dois grupos
- Abertura TCP de conexão nova (no genérico, também cada etapa do TLS). Ao estourar: connect timed out (destino fora do ar, sobrecarregado ou rede); aumentar não resolve.
CONNECTIONREQUESTTIMEOUTMS — padrão 10000 no FaaS, 5000 no genérico
- Espera na fila por conexão livre. Ao estourar: Timeout waiting for connection from pool.
- Faixa válida (fórmula 7): 10000 ≤ FAASCLIENT_HTTP_CONNECTIONREQUESTTIMEOUTMS < 15000 e abaixo do pool.connectionTimeout de cada tenant (11 a 14 s não testados).
- Abaixo de 10 s, perde execuções mesmo com carga saudável. Esperas longas prendem threads (≈ execuções/s × espera: com 30 s, cerca de 7 execuções/s por pod ocupam 200 threads; com 10 s, cerca de 20) e, como cada execução na fila segura uma conexão do pool de banco (inferência), passar de APP_DATASOURCE_POOL_CONNECTIONTIMEOUT (padrão 15000) ou do pool.connectionTimeout do tenant gera erros de banco e de autenticação enganosos (até 352 403 Access Denied numa rodada com 20 s).
- Aumentar, dentro da faixa, só para picos curtos acima da capacidade do node-faas; para preservar threads, use réplicas ou revise threads e cabeçalho.
READTIMEOUTMS — padrão 90000 no FaaS, 10000 no genérico
- Tempo máximo sem resposta (reinicia a cada trecho recebido). Ao estourar: Read timed out, conexão descartada e vaga liberada; é o que impede uma chamada presa de ocupar a vaga para sempre.
- Não limita a função: ela segue no node-faas com todos os efeitos (gravações, integrações); nova tentativa do usuário pode executá-la de novo.
- script.timeout do node-faas (padrão 60 s): no runtime 1.x (produção) só cobre o código até a primeira espera assíncrona (await de HTTP, banco, SDK ou setTimeout), e READTIMEOUTMS é o único limite efetivo; no 2.x, interrompe a função cerca de 61 s após o início da execução (a fila interna não conta).
- Aumentar para funções legitimamente longas (relatórios, integrações lentas, lote), junto com o script.timeout e o timeout do ingress.
KEEPALIVEMS — padrão 2000 nos dois grupos
- Tempo máximo de reaproveitamento de uma conexão ociosa; depois, abre-se outra (milissegundos no cluster).
- Deve ficar bem abaixo dos 5 s do node-faas (com Node.js 20, das imagens atuais, o fechamento ocorre exatamente no tempo anunciado); a margem de 3 s também absorve pausas do runtime 1.x (função síncrona longa impede a leitura das conexões). Ao errar: falhas esporádicas (tráfego baixo ou rajadas) com Connection reset ou <host>:<porta> failed to respond (NoHttpResponseException; ex.: node-faas:3000 failed to respond).
- 0 desliga o limite (vale só o Keep-Alive do servidor): não recomendado no FaaS; gera WARN, assim como valor não abaixo de 5 s.
- Melhoria recomendada no node-faas, fora desta versão: server.keepAliveTimeout (hoje 5 s) bem acima deste limite elimina o risco.
Timeouts 0 ou negativos = sem limite, como nas versões que travavam. Não recomendado; gera WARN.
Exemplo de ConfigMap
data:
FAASCLIENT_HTTP_MAXCONNPERROUTE: '50'
FAASCLIENT_HTTP_MAXCONNTOTAL: '200'
FAASCLIENT_HTTP_CONNECTTIMEOUTMS: '5000'
FAASCLIENT_HTTP_CONNECTIONREQUESTTIMEOUTMS: '10000'
FAASCLIENT_HTTP_READTIMEOUTMS: '90000'
FAASCLIENT_HTTP_KEEPALIVEMS: '2000'
APP_HTTPCLIENT_MAXCONNPERROUTE: '50'
APP_HTTPCLIENT_MAXCONNTOTAL: '200'
APP_HTTPCLIENT_CONNECTTIMEOUTMS: '5000'
APP_HTTPCLIENT_CONNECTIONREQUESTTIMEOUTMS: '5000'
APP_HTTPCLIENT_READTIMEOUTMS: '10000'
APP_HTTPCLIENT_KEEPALIVEMS: '2000'
- Valores entre aspas; declare só o que diferir do padrão (o exemplo equivale a não declarar nada).
- Lidas só na subida do pod: alterações exigem novo rollout (kubectl rollout restart deployment/<nome-do-deployment>).
- Valor não numérico (ex.: 5s) impede a subida: APPLICATION FAILED TO START com a propriedade e a variável (ex.: Property: faas-client.http.read-timeout-ms e Origin: System Environment Property, seguido de "FAASCLIENT_HTTP_READTIMEOUTMS"), código 1 e CrashLoopBackOff (num rollout, os pods antigos seguem atendendo e o rollout para). Veja com kubectl logs <pod> --previous.
Como verificar os valores em uso
Cada pod registra os valores efetivos uma vez: na primeira execução de FaaS e na primeira busca de token.
FaaS HTTP client: maxConnPerRoute=50, maxConnTotal=200, connectTimeoutMs=5000, connectionRequestTimeoutMs=10000, readTimeoutMs=90000, keepAliveMs=2000
REST HTTP client: maxConnPerRoute=50, maxConnTotal=200, connectTimeoutMs=5000, connectionRequestTimeoutMs=5000, readTimeoutMs=10000, keepAliveMs=2000kubectl logs -l app=<nome-do-deployment> --prefix --tail=-1 | grep "HTTP client"- Sem a linha: o pod ainda não executou FaaS ou não buscou token (casos em Parâmetros). Não é erro.
- --tail=-1 é necessário (com -l, saem só 10 linhas por pod). Com outro rótulo, use kubectl get pods e kubectl logs <nome-do-pod> | grep "HTTP client"; após rotação, a ferramenta de logs centralizada.
- Valor inválido (ex.: MAXCONNPERROUTE igual a 0) aparece já ajustado, seguido de WARN. Valores inesperados: confira a grafia (Parâmetros) e se o pod reiniciou após a alteração.
Como ajustar
- Timeout waiting for connection from pool (cliente recebe 409): fila do pool acima de CONNECTIONREQUESTTIMEOUTMS; deve ser rara no pico. node-faas saturado → réplicas dele. Com folga nele: falhas recorrentes → réplicas do Low Code, ou FAASCLIENT_HTTP_MAXCONNPERROUTE (MPR) até 100 se a fórmula 1 pedir (e até metade das threads); picos curtos → espera maior, abaixo de 15000 e do pool.connectionTimeout dos tenants.
- Read timed out (409): node-faas sem responder por READTIMEOUTMS. Função legitimamente longa → FAASCLIENT_HTTP_READTIMEOUTMS maior (e script.timeout) e, se acionada pelo navegador, a cadeia de entrada (Timeouts da cadeia de entrada); a função continua no node-faas. Sob carga → node-faas saturado, MPR acima da capacidade dele ou falta de threads para as chamadas de volta (fórmula 2).
- connect timed out: o node-faas não aceitou a conexão (pod caído ainda nos endpoints, rede ou NetworkPolicy descartando pacotes, sobrecarga); DNS falha como UnknownHostException, Service sem pods prontos como Connection refused. Investigue pods, Service e endpoints; aumentar o timeout só mascara.
- Connection reset ou failed to respond esporádicos: conexão reaproveitada já fechada (com o padrão, provável pausa longa do node-faas por código síncrono). Confirme KEEPALIVEMS bem abaixo de 5 s e diferente de 0; se persistir, FAASCLIENT_HTTP_KEEPALIVEMS=1000 (conexão nova custa menos de 1 ms) e identifique as funções síncronas longas. Definitivo: server.keepAliveTimeout maior no node-faas.
- Pod sem responder (nem aos health checks) numa lentidão do node-faas, ou health check lento com falhas por fila (e Read timed out, quando há poucas threads): faltam threads (fórmula 2). MPR até metade das threads, espera na faixa da fórmula 7, Health checks e revisão de threads, cabeçalho e heap.
- Unable to acquire JDBC Connection ou Connection is not available, request timed out after ...ms: pool de banco do tenant esgotado; reduza C_pod com réplicas e confira o pool (fórmula 5). Rajadas de 401 ou 403 Access Denied junto: efeito sobre a autenticação, não permissão (inferência).
- Erros encadeados BusinessObject -> BusinessObject -> ... nas chamadas das funções ao Low Code: nos testes, só com falta de memória ou pool de banco esgotado.
- Request header is too large (cliente recebe 400): requisição acima de SERVER_MAXHTTPHEADERSIZE; só a primeira ocorrência em INFO, as seguintes em DEBUG. HeadersTooLargeException em ERROR (cliente recebe 500): cabeçalho de resposta acima do limite.
- Falha ao obter token com os erros acima: mesmas causas no cliente genérico, ou provedor de identidade acima de APP_HTTPCLIENT_READTIMEOUTMS. Verifique o provedor; se for legitimamente lento, aumente APP_HTTPCLIENT_READTIMEOUTMS (ex.: 15000).
Timeouts da cadeia de entrada
Para funções acionadas pelo navegador vale o menor timeout da cadeia (balanceador, roteador, ingress); se um componente desistir antes, o navegador recebe 504 Gateway Timeout e a execução continua no servidor. Tempo máximo no Low Code, com os padrões:
- fila (10 s) + conexão (5 s, só se nova) + resposta (90 s): até cerca de 105 s; com busca de token antes (recursos públicos com credenciais do projeto: 5 + 5 + 10 s), até cerca de 125 s;
- função que chama outra pelo Low Code: cada nível soma nova fila e nova execução;
- sob sobrecarga, as esperas do pool de banco somam até mais 2 × 15 s (medido: 90,4 s com FAASCLIENT_HTTP_MAXCONNPERROUTE 50, 119,5 s com 100 e 132 s com 150); os 130000 do exemplo do Kong ficam no limite.
Confira o componente à frente do Low Code em cada ambiente:
- Kong (ingress do repositório): padrão 60 s; konghq.com/read-timeout e konghq.com/write-timeout no Service (ms). Anotações do ingress-nginx não têm efeito no Kong.
- OpenShift Route: padrão 30 s; haproxy.router.openshift.io/timeout (ex.: 130s). Na AWS, a ociosidade do balanceador também precisa acompanhar.
- ingress-nginx: padrão 60 s; nginx.ingress.kubernetes.io/proxy-read-timeout e nginx.ingress.kubernetes.io/proxy-send-timeout (segundos).
Exemplo para o Kong, no Service do Low Code, acomodando os padrões (até cerca de 125 s; sob sobrecarga, fica no limite):
metadata:
annotations:
konghq.com/read-timeout: "130000"
konghq.com/write-timeout: "130000"Se as funções acionadas pelo navegador forem sempre rápidas, não é preciso alterar.
Health checks
Os probes (/lowcode/management/health/liveness e /readiness) usam as mesmas threads de telas, APIs e FaaS; uma lentidão do node-faas pode atrasá-los e reiniciar vários pods juntos.
- Liveness com timeoutSeconds: 5 e failureThreshold: 3, nunca failureThreshold: 1 (o template de referência usa 1, com 1 s). Mesmo assim, um colapso prolongado reinicia os pods.
- Opcional: porta própria com MANAGEMENT_SERVER_PORT (ex.: 9090). Porta e caminho mudam juntos: probes (liveness, readiness e startup, se houver) em 9090 com /management/health/liveness e /management/health/readiness, sem /lowcode; mudar só um faz os probes falharem. Declarar a porta em ports é recomendado (obrigatório só se o probe usar o nome dela). Com porta separada, o readiness deixa de refletir a saturação das threads principais.
Ajuste de heap, threads e cabeçalho (todos os ambientes)
Esta versão não altera o heap, SERVER_MAXHTTPHEADERSIZE (10MB) nem SERVER_TOMCAT_THREADS_MAX (200); o cabeçalho de 10MB e as 200 threads valem desde a 0.7.4 (2022). Com heap de 4 GB, essa configuração ficou sem memória com cerca de 180 requisições simultâneas por pod, qualquer que fosse MAXCONNPERROUTE (25, 50, 100) ou CONNECTIONREQUESTTIMEOUTMS (5, 10, 20, 30 s). O risco não foi introduzido pela 1.18.4; voltar para a 1.18.3 não o elimina e traz de volta o travamento. Revise esta seção em todos os ambientes. Os limites valem por pod; o total no node-faas e no PostgreSQL é o limite × réplicas. Nesta seção, MPR = FAASCLIENT_HTTP_MAXCONNPERROUTE, T = SERVER_TOMCAT_THREADS_MAX e H = SERVER_MAXHTTPHEADERSIZE.
Parametrização por faixa de heap
- Heap efetivo: -Xmx, ou limite do container × MaxRAMPercentage (70% de 4Gi ≈ 2,8 GiB); sem nenhum dos dois, 25% do limite (1 GiB com 4Gi). Entre faixas, use a inferior ou a fórmula 3.
- Uso intenso: X_pod acima de 40, falhas por fila recorrentes em pico normal, ou C_pod acima do que o uso normal da faixa comporta.
- Tetos com 10MB (130, 200, 270) supõem base até 0,4 GB e nenhuma conexão longa; senão, fórmula 3 ou 64KB. Nos limites com − O, substitua O; os vindos só da fórmula 5 (180 − K, 130, 80) ainda não descontam os demais usos do banco.
- Demais parâmetros e pool de banco: padrões. Números medidos, emulados (4 GB com cabeçalho de 7400KB para 6 GB e 5120KB para 8 GB) ou calculados, num ambiente local (Validação): dimensione pelas fórmulas.
Abaixo de 4 GB (inclui o template de referência: limite de 4Gi, MaxRAMPercentage=70)
- Distribuída: falta memória a partir de cerca de 115 a 120 simultâneas (calculado). Use a recomendação de 4 GB com 64KB.
- Sem 64KB: aumente o limite do container até a faixa de 4 GB (cerca de 5,7Gi) e aplique 130 threads com mais réplicas; só aumentar o heap não basta. Mantendo cerca de 2,8 GiB e 10MB, a fórmula 3 dá cerca de 85 threads: cerca de 15 execuções simultâneas (85 − 50 − 20) menos O, e o MPR 50 passa de T ÷ 2 (cerca de 42). Não recomendado.
Heap de 4 GB
- Distribuída: não é segura. cerca de 130 requisições em processamento com folga de 15%, falta de memória acima de cerca de 170 (calculado) e OutOfMemoryError com 180 em todas as configurações testadas (com node-faas lento, entre 120 e 220), de qualquer tipo de requisição. Após o erro, a JVM não encerra e fica degradada (50% a 79% do tempo em coleta); não foi testado se o liveness reinicia o pod nesse estado.
- Uso normal (recomendado mesmo sem uso intenso):
- Preferencial, após verificar os logs de acesso: SERVER_MAXHTTPHEADERSIZE=64KB, 200 threads, MPR 50 (nenhuma rodada 64KB ficou sem memória). Capacidade: C_pod ≤ 130 − O (fórmulas 2 e 5).
- Com 10MB necessário: SERVER_TOMCAT_THREADS_MAX=130 (ou menos, pela fórmula 3): sem falta de memória até 220 simultâneas, mas capacidade de cerca de 60 − O (130 − 50 − 20 − O).
- Não aplique os 130 sozinho: cargas de cerca de 110 a 170 simultâneas que hoje funcionam com 200 threads passam a colapsar. Verifique os logs primeiro (com 64KB o corte é desnecessário); se cortar, faça no rollout do aumento de réplicas, ou depois, com C_pod ≤ 60 − O (fórmula 6). Até lá, mais réplicas e -XX:+ExitOnOutOfMemoryError.
- Uso intenso: SERVER_MAXHTTPHEADERSIZE=64KB, SERVER_TOMCAT_THREADS_MAX=400 e MPR 50 (100 só se a fórmula 1 pedir e o node-faas comportar 100 × maxReplicas). O limite passa a ser o banco: C_pod ≤ 180 − K (130 no pior caso com MPR 50); exige a verificação do PostgreSQL. Com 10MB, não há opção viável de uso intenso em 4 GB: aumente heap ou réplicas.
Heap de 6 GB
- Distribuída: no limite. Segura só com base até cerca de 0,4 GB e sem conexões longas relevantes: 200 threads são o teto da fórmula 3 (pico cerca de 85% calculado; cerca de 95% com base de 1 GB, o que leva à falta de memória). Capacidade limitada pelas threads: C_pod ≤ 130 − O no pior caso de chamadas de volta (cerca de 180 − O com chamadas curtas, como nos testes).
- Uso normal: meça a base; se couber, nada a alterar. Senão, 64KB (após os logs de acesso) ou threads pela fórmula 3 com mais réplicas. Não aumente as threads com 10MB.
- Uso intenso: preferencial igual a 4 GB (64KB, 400 threads, MPR 50 ou 100; com 6 GB há mais folga). Com 10MB necessário: no máximo 200 threads (ou a fórmula 3), MPR 50 e réplicas até C_pod ≤ 130 − O; ou heap de 8 GB.
Heap de 8 GB
- Distribuída: memória com folga; o limite são as threads (com as 200 ocupadas, cerca de 64% do heap calculado, cerca de 71% com base de 1 GB).
- Uso normal: nada a alterar; limites de C_pod iguais aos de 6 GB (130 − O).
- Uso intenso: mantendo 10MB, SERVER_TOMCAT_THREADS_MAX=270 e MPR 50 (teto com base 0,4 GB; cerca de 245 com base de 1 GB; pico cerca de 84% num heap real, calculado). Fórmula 2: C_pod ≤ 200 − O (MPR 50) ou 150 − O (MPR 100); fórmula 5: C_pod ≤ 130 (MPR 50) ou 80 (MPR 100) no pior caso; use o menor. MPR 100 não testado com 270 threads. Alternativa, após os logs de acesso: 64KB e 400 threads. Nos dois casos, verifique o PostgreSQL antes de passar de 200 threads.
Ordem das alterações
- Heap: confirme o heap efetivo (-Xmx em JAVA_TOOL_OPTIONS ou JDK_JAVA_OPTIONS, ou limite × MaxRAMPercentage), escolha a faixa e meça a base. Confira também application-*.yml montados (server.max-http-header-size, server.tomcat.threads.max ou o antigo server.tomcat.max-threads) e SERVER_TOMCAT_MAXTHREADS, nome antigo ainda aceito.
- kubectl exec <pod> -- env | grep -E '^(JAVA_TOOL_OPTIONS|JDK_JAVA_OPTIONS|SERVER_MAXHTTPHEADERSIZE|SERVER_TOMCAT_THREADS_MAX|SERVER_TOMCAT_MAXTHREADS|SPRING_CONFIG_[A-Z_]+)=' kubectl get pod <pod> -o jsonpath='{.spec.containers[0].resources.limits.memory}{"\n"}{.spec.containers[0].volumeMounts}{"\n"}'
- Health checks e falta de memória: antes de qualquer aumento de carga, liveness 5 s × 3 e -XX:+ExitOnOutOfMemoryError.
- Logs de acesso: antes de reduzir o cabeçalho, procure requisições acima de 64 KB (Cuidados).
- Cabeçalho antes das threads: aplique SERVER_MAXHTTPHEADERSIZE antes de aumentar SERVER_TOMCAT_THREADS_MAX. Com 10MB, nunca acima do teto da faixa nem da fórmula 3. Redução de threads só com o aumento de réplicas, ou depois. Para voltar a 10MB (ex.: cliente recebendo 400 após 64KB): threads de volta ao teto da faixa antes ou no mesmo rollout (só remover SERVER_MAXHTTPHEADERSIZE com 400 threads exige cerca de 9,6 GB de buffers); antes, considere 128KB ou 256KB.
- PostgreSQL: antes de passar de 200 threads, max_connections e pool de cada tenant (Cuidados).
- Réplicas: HPA (minReplicas e maxReplicas, com a réplica extra) e réplicas do node-faas (fórmulas 4 e 6), antes de aumentar o MPR.
- MPR: só agora, se a fórmula 1 pedir e o node-faas comportar: FAASCLIENT_HTTP_MAXCONNPERROUTE=100.
- Demais FAASCLIENT_HTTP_*: só diante de sintoma (Como ajustar).
Um item por vez (exceto a redução de threads, que acompanha as réplicas); cada alteração exige rollout, fora do pico; observe um pico real antes da próxima.
Como verificar após a alteração
- FaaS: linha FaaS HTTP client sem WARN em seguida. Exemplo com MPR 100:
FaaS HTTP client: maxConnPerRoute=100, maxConnTotal=200, connectTimeoutMs=5000, connectionRequestTimeoutMs=10000, readTimeoutMs=90000, keepAliveMs=2000- Threads e cabeçalho não aparecem no log: use os comandos do item 1 de Ordem das alterações (sem definição, valem 10MB e 200). Para o limite de cabeçalho, envie 70 KB: 400 = rejeitado (como com 64KB); outro status = aceito (com MANAGEMENT_SERVER_PORT, a 8080 responde 404, também aceito).
# em um terminal
kubectl port-forward pod/<pod> 8080:8080
# em outro terminal
curl -s -o /dev/null -w '%{http_code}\n' -H "X-Teste: $(head -c 70000 /dev/zero | tr '\0' a)" http://localhost:8080/lowcode/management/health/readiness- Falta de memória: nenhum OutOfMemoryError (nos testes, Failed to complete processing of a request seguido de java.lang.OutOfMemoryError: Java heap space); se houver, reinicie o pod e revise cabeçalho e threads. Com -XX:+ExitOnOutOfMemoryError, sai Terminating due to java.lang.OutOfMemoryError e o container reinicia (kubectl logs <pod> --previous).
kubectl logs -l app=<nome-do-deployment> --prefix --tail=-1 | grep "OutOfMemoryError"- Health check no pico: readiness abaixo de 1 s (até 169 ms nas rodadas saudáveis); sem eventos Unhealthy nem aumento em RESTARTS. Health check rápido não descarta colapso por pool de banco (até 204 ms nesse colapso): confira as mensagens (Como ajustar). Falta de memória: 2 a 16 s; falta de threads: 12 a 26 s.
curl -s -o /dev/null -w '%{http_code} %{time_total}s\n' http://localhost:8080/lowcode/management/health/readiness
kubectl get events --field-selector reason=Unhealthy
kubectl get pods -l app=<nome-do-deployment>Cuidados
- Cabeçalho de 64KB: antes, procure requisições acima de 64 KB na linha de requisição + cabeçalhos (filtros longos na URL, cookies, tokens); logs de acesso comuns não registram esse tamanho:
- Ingress: $request_length (nginx) ou request.size (Kong), só triagem: incluem o corpo, e pipelines de log truncam linhas longas.
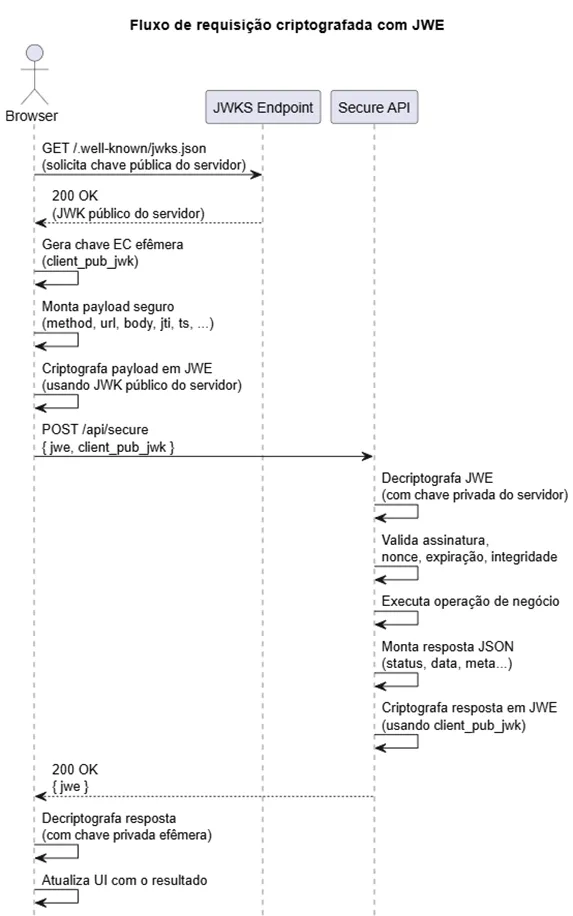
- URL longa conhecida: GET /lowcode/api/secure?jwe=...&client_pub_jwk=... (SDK para SSE).
- Chamadas internas (ex.: node-faas → Low Code) não são registradas: use um pod canário com 64KB e procure Request header is too large.
- O tráfego externo provavelmente já é limitado (ingress nginx: 4 × 8 KB; roteador do OpenShift: cerca de 32 KB); o risco está nas chamadas internas. Cabeçalho de resposta grande (Set-Cookie, Content-Disposition) dá 500 (não testado com 64KB).
- O 10MB existe desde a 0.7.4 sem motivo documentado. Se algum cliente precisar de mais, 128KB ou 256KB (cerca de 100 e cerca de 200 MB com 400 threads; calculado, não testado).
- Conexões longas com 10MB: cada SSE aberto ou requisição recebida em parte custa 22 a 24 MB além das threads, sem limite prático (8192 conexões). Se forem muitas, 64KB.
- PostgreSQL ao aumentar threads: com um tenant ativo por pod, nada muda; com vários, 270 ou 400 threads podem aumentar as conexões por pod na mesma proporção. Confira se max_connections ≥ (maxReplicas + pods extras do rolling update) × (o menor valor entre T + tarefas em segundo plano e a soma dos maximumPoolSize dos tenants ativos no pod, mais os pools de conexões dinâmicas, 100 cada por padrão) + outros clientes + reserva. Confira também o pool de cada tenant (fórmulas 5 e 7). Não aumente APP_DATASOURCE_POOL_MAXIMUMPOOLSIZE para ganhar capacidade de FaaS.
- node-faas: recebe MPR × réplicas do Low Code (com pods do HPA e do rolling update); MPR acima da capacidade só transfere a fila e gera Read timed out.
- Probes: com falta de memória (health check de 2 a 16 s), o liveness de 5 s detecta ainda menos o estado degradado; daí -XX:+ExitOnOutOfMemoryError (encerra no primeiro OutOfMemoryError e o Kubernetes reinicia; não testado). 400 threads é o maior valor testado.
- HPA por CPU: com 64KB e 400 threads, média de 0,5 a 2,1 núcleos (amostra de 4,8; 0,5 a 0,7 no colapso); contra o request de 1 CPU e o alvo de 65% do template, não dá para prever se o HPA cria pods num colapso, e eles somariam conexões e execuções sem resolver. Limite maxReplicas pela fórmula 4 e pelo PostgreSQL.
- Memória do container (MaxRAMPercentage=70): heap de 4 GB exige cerca de 5,7Gi; 6 GB, cerca de 8,6Gi; 8 GB, cerca de 11,4Gi (memória fora do heap não medida).
- Homologação: teste as configurações de uso intenso em homologação, com o runtime de produção do node-faas.
O que cada execução de FaaS ocupa
- Uma thread do Tomcat durante todo o percurso e uma vaga do pool FaaS enquanto aguarda o node-faas.
- Uma conexão do pool de banco do tenant (inferência): padrão de 200 por tenant e por pod (APP_DATASOURCE_POOL_MAXIMUMPOOLSIZE), espera de até 15 s (APP_DATASOURCE_POOL_CONNECTIONTIMEOUT).
- Mais uma thread e uma conexão a cada chamada da função ao Low Code (chamada de volta).
- Heap para buffers de cabeçalho: cerca de 2 × SERVER_MAXHTTPHEADERSIZE por requisição em processamento (qualquer uma, inclusive health checks, seja qual for o tamanho real dos cabeçalhos) e por conexão aberta sem thread (SSE, respostas assíncronas, requisições recebidas em parte). Com 10MB, 22 a 24 MB por requisição, conforme a região do G1 (22 MB medidos com -Xms2g -Xmx4g; 24 MB calculados para -Xms4g -Xmx4g e para heaps de 6 e 8 GB com -Xms2048m). Após um pico, o Tomcat retém até cerca de 200 processadores, sem passar dos que chegaram a ser usados, cada um com os dois buffers (cerca de 200 × 2 × H: 4,4 a 4,8 GB com 10MB; com 130 threads, 2,75 GB vivos mesmo após coleta completa forçada), reaproveitados no pico seguinte.
Fórmulas de dimensionamento
Grandezas, por pod:
- R: réplicas no pico (pior caso: maxReplicas). X_pod (lei de Little) = (pico de execuções/s no cluster ÷ R) × tempo médio da execução em s, com a fila do node-faas.
- C_pod: pico de requisições de FaaS simultâneas, com a fila do pool (cerca de X_pod em regime normal; cresce numa lentidão do node-faas).
- K: chamadas de volta simultâneas, de 0 a MPR; passa de MPR com chamadas paralelas (Promise.all) ou /faas/run (que também ocupa o pool FaaS). O: demais requisições (telas, APIs, integrações).
- S: conexões longas sem thread: SSE (importação e instalação de pacotes do designer, que não expiram; /{bo}/sse; /adapter/sse), streams do SDK por GET /lowcode/api/secure?jwe=... e requisições recebidas em parte; único limite: server.tomcat.max-connections (8192).
- MPR = FAASCLIENT_HTTP_MAXCONNPERROUTE; T = SERVER_TOMCAT_THREADS_MAX; H = SERVER_MAXHTTPHEADERSIZE; Xmx = heap máximo efetivo.
- MPR: MPR = 50 se 1,25 × X_pod ≤ 50; MPR = 100 se 1,25 × X_pod ≤ 100; acima disso, aumente réplicas (fórmula 6). Nunca acima de 100 (150 gerou de 136 a 146 Read timed out, de 43 a 361 erros de banco ou de autenticação e fila de até 250 no node-faas). Mantenha MPR ≤ T ÷ 2. Cada pod atende no máximo cerca de MPR ÷ tempo médio da execução execuções/s.
- Threads: T ≥ C_pod + K + O + 20 (health checks e folga). Acima de T, health check de 12 a 26 s e sucesso de 17% a 38%, mesmo com memória sobrando.
- Heap: pico ≈ base + P × custo, com P = requisições em processamento (até T) + S. Custo: 24 MB com 10MB; cerca de 0,13 MB com 64KB (400 threads ≈ 50 MB; mil conexões longas ≈ 130 MB).
- Base: meça a do ambiente (G1 Old Gen logo após uma coleta, sob carga normal), de preferência num pod com 64KB: com 10MB, a medida inclui os buffers retidos do maior pico, a descontar. No teste, 0,18 a 0,41 GB (0,4 GB é a escolha conservadora usada abaixo); em produção (vários tenants, caches, respostas grandes), pode chegar a cerca de 1 GB.
- Folga-alvo de 15%: T ≤ (0,85 × Xmx − base) ÷ 24 MB − S. Base 0,4 GB e S = 0: cerca de 130 (4 GB), 200 (6 GB), 270 (8 GB), os tetos das faixas. Base 1 GB: cerca de 100, 175 e 245 (200 threads em 6 GB chegam a cerca de 95% e 270 em 8 GB a cerca de 92%; nos dois casos, falta memória). Sem medir base nem S, use 0,75 (cerca de 110, 175 e 240) ou 64KB.
- Folga medida nos tetos: pico da geração antiga de 77,5% (4 GB, 130 threads), 88,1% (6 GB emulado, 200) e 87,0% (8 GB emulado, 270); folga de 12% a 13% nas emulações, estimativa de 82% a 85% num heap real; somando os objetos temporários, o uso chegou a 93,5%.
- node-faas: MPR × (maxReplicas do Low Code + pods extras do rolling update) ≤ réplicas do node-faas × execuções simultâneas seguras por réplica. O runtime 1.x não limita execuções simultâneas: meça essa capacidade em teste de carga.
- Banco, por tenant e por pod: C_pod + K + demais usos do banco ≤ 90% do pool do tenant (180 com o padrão de 200); margem de planejamento, não limite medido. pool.maximumPoolSize e pool.connectionTimeout do recurso de banco (DATABASE) do tenant prevalecem: confira em cada tenant.
- Réplicas: C_pod_alvo = maior C_pod que atende 2, 3 e 5; minReplicas = arredondamento para cima de (pico de execuções simultâneas no cluster ÷ C_pod_alvo) + 1. A réplica extra cobre um pod a menos: com o maxUnavailable de 25% do template, num rolling update ou perda de pod os demais recebem até cerca de 1/3 a mais (ou use maxUnavailable: 0). Rollouts fora do pico.
- Espera na fila: 10000 ≤ FAASCLIENT_HTTP_CONNECTIONREQUESTTIMEOUTMS < menor espera do pool de banco entre os tenants (APP_DATASOURCE_POOL_CONNECTIONTIMEOUT, padrão 15000, ou pool.connectionTimeout). Tenant com pool.connectionTimeout abaixo de 10000 quebra a regra já com o padrão (401 e 403 enganosos): ajuste-o para pelo menos 15000.
Exemplo: 3 réplicas, 120 execuções/s, 1,5 s por execução, K até MPR, O = 20. X_pod = (120 ÷ 3) × 1,5 = 60; 1,25 × 60 = 75 > 50 → MPR = 100; threads 60 + 100 + 20 + 20 = 200, acima do teto de 130 (4 GB com 10MB): 64KB com 400 threads ou heap de 8 GB com 270 (fórmula 5: 160 ≤ 180). Com 6 réplicas: X_pod = 30, MPR = 50, threads 120; C_pod_alvo = 130 − 50 − 20 − 20 = 40, minReplicas = ⌈(120 × 1,5) ÷ 40⌉ + 1 = 6. Escalar horizontalmente costuma ser o mais simples.
Validação
Ambiente: uma máquina (32 núcleos, sem limite de CPU), um Low Code 1.18.4, um node-faas (runtime 2.x, até 4 funções por vez, cerca de 24 a 45 execuções/s) e um tenant. Função de teste: consulta a objeto de negócio (100 a 150 ms) que chama o Low Code. Clientes em ciclo fechado ("simultâneas × execuções por cliente"); JVM -Xms2g -Xmx4g (G1, regiões de 1 MB); readiness medido a cada 1 s; lentidão simulada com +1,5 s por chamada. Nas rodadas por faixa de heap, percentuais = geração antiga; nas demais, valores em GB = heap total com objetos temporários (com 64KB, geração antiga até 0,4 GB).
Heaps de 6 e 8 GB emulados (sem memória livre na máquina): heap de 4 GB com 7400KB (16 MB por requisição, 4/6 de 24 MB) e 5120KB (12 MB, 4/8). Os 24 MB num heap real de 6 ou 8 GB são calculados (supondo -Xms2048m), não medidos; como a base pesa mais em 4 GB, heaps reais teriam um pouco mais de folga. Uma primeira emulação de 6 GB com 6826KB (14 MB, cerca de 12,5% otimista) teve 97,9%, 98,8% e 37%.
Distribuída (10MB, 200 threads), 4 GB, seis configurações do pool FaaS (padrão; esperas de 5, 20 e 30 s; MPR 25 e 100)
- 100 × 6: 100%, heap até 2,73 GB. 150 × 6: 99,1% a 100% (espera de 5 s: 96,1%), geração antiga em 93% (97% a 98% com temporários).
- 180 × 6: OutOfMemoryError nas seis em 2 a 4 s; 82,9% a 92,5%; 50% a 65% do tempo em coleta; health check até 4,1 s.
- Nenhum MPR ou espera mudou esse ponto. Abaixo dele, MPR 100 teve p95 de 4,9 s com 150 (padrão: 6,8 a 9,6 s).
Faixas com 10MB (14 medições, espera de 10 s)
- 4 GB, 130 threads (medido): até 77,5%, sem falta de memória até 220. 130 simultâneas: 89,7% (health check de 12,9 s); 180: 32,9% e 12 Read timed out (só 367 das 1.080 chamadas chegaram ao node-faas, por falta de threads para as chamadas de volta); 220: 26,9%, 34 Read timed out (até 26,2 s).
- 6 GB, 200 threads (emulado): 150 e 180: 99,2% e 99,4% (até 80 ms); 220: 38,3% (até 13 s; 88%). Heap real de 6 GB (rodada anterior, fora das 14 medições; não registrou coleta de lixo nem espera na fila): 100% com 150 e 180, health check abaixo de 150 ms.
- 8 GB, 200 threads (emulado): 180: 98,4% (até 98 ms); 220 e 260: 37% e 29,9% (até 13,7 s); até 63%.
- 8 GB, 270 threads (emulado): 220 e 260: 86,2% e 84,6%, até 124 ms, falhas só por fila; pico de 87%.
- Nenhuma falta de memória, coleta completa ou erro de banco; Read timed out só com 130 threads.
- Modelo de memória: a fórmula 3 previu a memória após o pico com erro de até 3,2%, mas, com a base do pod ocioso (102 a 121 MB), ficou abaixo do pico medido nas 14 medições (geração antiga de 2,4% a 10% acima do previsto). Requisições em processamento = menor valor entre as threads e "simultâneas + cerca de 5" (chamadas de volta e health checks).
64KB e 400 threads, 4 GB (MPR 50, 100 e 150 com 10 s; MPR 100 com 20 s)
- Cabeçalho: 60.000 bytes, 200; 70.000 e 200.000, 400; token na URL (cerca de 1,7 KB), 200.
- 180 × 6: 99,4% a 100%, health check até 115 ms, heap até 1,44 GB.
- 300 × 4: colapso (35,9% a 55,9%). MPR 50: 43%, só falhas por fila, health check até 99 ms (só cerca de 8 execuções/s chegaram ao node-faas, contra cerca de 38 com 180; causa não diagnosticada). MPR 100: 62 Read timed out; MPR 150: 136 Read timed out e 43 erros de banco ou de autenticação; 20 s: 405 desses erros (198 403 Access Denied) e 364 por fila.
- 420 × 3: 16,6% a 29%, health check de 12,1 a 14,3 s, heap até 1,53 GB. MPR 100: 91 Read timed out; MPR 150: 146 Read timed out, 361 erros de banco ou de autenticação e fila de 250 no node-faas; 20 s: 599 erros (352 403 Access Denied) e 296 por fila.
- MPR 100 dobra as chamadas simultâneas enviadas ao node-faas (de 51 para 101; o runtime local executou no máximo 4 por vez): melhora vazão e tempo abaixo do limite, mas sob sobrecarga gerou de 62 a 91 Read timed out.
- Colapso entre 260 (270 threads) e 300 simultâneas (400 threads), em configurações diferentes; atribuí-lo ao pool de banco é inferência (PostgreSQL com 198 a 207 conexões desde 180 simultâneas; em 4 de 6 thread dumps, chamadas ao node-faas + esperas na fila = exatamente 200). Com 300, nenhum MPR ou espera o evitou.
node-faas lento, 4 GB
- 10MB, 200 threads: 100% com 60 e 120 (espera de 5 s com 120: 96,7%); com 120, geração antiga já em 3,0 a 3,1 GB (3,1 a 3,2 GB de heap total); 220: OutOfMemoryError, 22,7% a 52,4%, 70% a 79% em coleta, health check de 11,4 a 16,3 s.
- 64KB, 200 threads, MPR 50: 100% com 60 e 120 (heap de 1,2 a 1,3 GB); 220: 37,4% e 13,3 s (threads).
- 64KB, 400 threads, MPR 100: 100% com 60 e 120 (33,6 execuções/s, contra 26,1 com MPR 50 e 200 threads); 220: 84,8%, até 101 ms.
Espera na fila: 5 s perdeu 3,9% com 150 e 3,3% com 120 e node-faas lento; 10 s, 0 a 2,1% até 180 (0 a 1,6% sem a primeira emulação de 6 GB); 20 s gerou os erros de banco e de autenticação acima; 30 s, com 300 simultâneas, levou o health check a 32,9 s (11% de sucesso, 81% de falhas por fila e 8% de Read timed out; rodada de 222 s). Este resultado e o de 5 s com 150 simultâneas (89% de sucesso, 11% de falhas por fila) vêm das primeiras rodadas, antes de fixar o heap em 4 GB, e não são diretamente comparáveis.
Reutilização de conexões ociosas (comportamento do Node.js 20): sem limite, falhas numa faixa de cerca de 2 ms abaixo de 5 s de ociosidade (179 em 4.100 tentativas; nenhuma falha em 2.700 tentativas com pausas fixas entre 3,9 e 5 s) e, com travamentos de cerca de 0,9 s, a partir de 4,5 s. Limite de 4 s: nenhuma falha em 6.800 tentativas sem travamento, mas travamentos de 1,5 s ou mais ainda falharam. Limite de 2 s: travamentos de até 2,9 s sem falhas. O ambiente local (Node.js 24, que mantém a conexão 1 s além do anunciado) não reproduziu o problema em 84 execuções.
Resultado: nenhuma execução ficou presa indefinidamente, ao contrário das 1.18.1 a 1.18.3.
O que não foi medido
- Produção: runtime 1.x, várias réplicas, vários tenants por pod, max_connections, pools por tenant fora do padrão, base de memória real e conexões longas sob carga.
- Heaps reais de 6 e 8 GB no limite; 64KB com 6 e 8 GB; limite de CPU de 2 núcleos (a média de 2,1 e o pico de 4,8 já o passam); memória fora do heap e OOMKilled.
- Threads diferentes de 130, 200, 270 e 400; MPR acima de 150; MPR 100 com 270 threads e nas rodadas por faixa de heap; espera de 11 a 14 s; 128KB e 256KB; -XX:+ExitOnOutOfMemoryError; os demais parâmetros sob carga e o APP_HTTPCLIENT_*.
- Cabeçalhos de resposta grandes com 64KB; /faas/run; chamadas de volta paralelas; chegada contínua de requisições numa lentidão (testes em ciclo fechado, até cerca de 4 chamadas de volta simultâneas; o proxy de atraso não ocupou worker do node-faas nem thread de chamada de volta): funções lentas ou com muitas chamadas ao Low Code podem esgotar threads e conexões antes do medido.
- Probes no Kubernetes real: só o tempo do readiness, com sondagem sequencial. Com falta de memória, travamentos de 2 a 16 s; de 2 a 7 sondagens por nível passaram de 1 s (timeout do liveness do template) e de 5 a 47 não retornaram 200; reinício pelo liveness possível, não testado.
Os números são de um ambiente de desenvolvimento e servem como referência de comportamento, não de capacidade de produção.
Este documento pressupõe que a atualização está sendo feita da versão 1.18.3 para a 1.18.4. Caso esse não seja o seu cenário, siga as orientações das Notas de Release anteriores, começando pela versão atualmente instalada no ambiente até alcançar a versão 1.18.3.
🐳 Imagens Docker
Utilize a imagem abaixo, conforme o ambiente:
Central IT
Esta versão não exige migração de dados e não requer atualização do FaaS.
As novas variáveis (FAASCLIENT_HTTP_* e APP_HTTPCLIENT_*) têm padrão; nenhuma é obrigatória. Recomenda-se:
- Funções FaaS com mais de 90 s sem resposta: configurar FAASCLIENT_HTTP_READTIMEOUTMS antes do deploy (Mudanças de comportamento).
- Ajustar o timeout do componente de entrada (Kong, OpenShift Route ou ingress-nginx), se funções acionadas pelo navegador puderem demorar mais (Timeouts da cadeia de entrada).
- Revisar os health checks (Health checks).
- Revisar heap, threads e cabeçalho conforme Parametrização por faixa de heap, mesmo sem uso intenso de FaaS (ver Resumo para a infraestrutura). O risco de falta de memória existe desde a 0.7.4; voltar para a 1.18.3 não o elimina e traz de volta o travamento.
- Remover FAASCLIENT_DEFAULTCONNECTION_CONNECTIONTIMEOUT do ConfigMap, se existir (não é lida desde a 1.8.7).
- Após o deploy, conferir as linhas FaaS HTTP client: ... e REST HTTP client: ... sem WARN; a segunda só aparece após uma busca de token (Como verificar os valores em uso).
- Alterações posteriores no ConfigMap só valem após novo rollout (Exemplo de ConfigMap).
Ambientes com imagem corrigida manualmente a partir da 1.18.3 (tag não oficial) devem migrar para a 1.18.4-RELEASE oficial: correção equivalente, com limites configuráveis, padrões calibrados e reutilização de conexões ociosas limitada.
Mudanças de comportamento
- Execuções simultâneas no node-faas, por pod: sem limite até a 1.18.0; apenas 2 da 1.18.1 à 1.18.3 (causa do travamento); 50 na 1.18.4.
- Espera por conexão livre: não se aplicava até a 1.18.0; indefinida da 1.18.1 à 1.18.3; 10 s na 1.18.4, depois erro.
- Tempo sem resposta do node-faas: sem limite da 1.8.7 à 1.18.3; 90 s na 1.18.4, depois erro (a função continua no node-faas).
- Busca de token: sem timeout até a 1.18.3; sem limite de buscas simultâneas até a 1.18.0; apenas 2 por pod da 1.18.1 à 1.18.3, com fila indefinida; na 1.18.4, até 50 simultâneas, fila de até 5 s e resposta em até 10 s, depois erro.
Principal mudança percebida: funções FaaS que passam mais de 90 s sem responder passam a falhar no Low Code. Se existirem, configure FAASCLIENT_HTTP_READTIMEOUTMS antes da atualização.
Data: de publicação: 30/09/2026
Esta versão do Low Code Web complementa as correções introduzidas na versão 1.18.2, ampliando a compatibilidade com formatos antigos de configurações gerais da plataforma. A atualização também inclui uma nova migração automática do banco de dados e testes adicionais para garantir maior confiabilidade no carregamento dos Settings.

⚙️ Correção na recuperação dos parâmetros gerais do Low Code
Corrigido o carregamento das configurações gerais da plataforma (Settings) em ambientes que ainda apresentavam falhas após a atualização para a versão 1.18.2. O ajuste amplia o reconhecimento de formatos antigos armazenados na coluna general da tabela settings, evitando erros que poderiam afetar operações comuns da plataforma, como consultas de objetos de negócio, registro de logs, autenticação e inicialização da aplicação.
O que foi corrigido:
- Leitura compatível com diferentes formatos antigos: o conversor GeneralSettingsConverter passou a reconhecer arrays que contenham exatamente um objeto de configurações, mesmo quando os demais elementos forem nulos ou textos. Isso contempla formatos como [null, {...}], ["<texto>", {...}] e [{...}], permitindo recuperar corretamente as configurações armazenadas.
- Tratamento de valores vazios: valores como null, [] e [null], inclusive quando contêm espaços em branco, passam a ser interpretados como ausência de configurações gerais, em vez de provocar falhas durante a leitura.
- Validação de formatos inválidos: arrays que não correspondam aos formatos previstos, como aqueles que contêm mais de um objeto de configurações, continuam sendo rejeitados com erro. Isso evita que dados realmente inválidos sejam aceitos silenciosamente.
- Nova migração para normalização dos dados: foi adicionada a migração 20260930-normalize-general-settings-legacy-arrays, executada automaticamente pelo Liquibase durante a inicialização da aplicação. Ela converte os formatos antigos de arrays para objetos JSON simples e limpa os arrays vazios, como [] e [null]. Registros com JSON inválido são ignorados com a emissão de um aviso, sem interromper a migração. O processo é idempotente: registros que já estão no formato correto não são alterados.
- Ampliação dos testes automatizados: os testes do conversor foram atualizados para contemplar os formatos [null, {...}] e [{...}], valores vazios com e sem espaços e a rejeição de arrays com mais de um objeto. Isso ajuda a garantir que os diferentes cenários sejam tratados corretamente.
Observação técnica
As migrações 20260418-add-log-metrics e 20260928-normalize-general-settings não foram alteradas. Como já foram aplicadas em ambientes atualizados, modificar seu conteúdo poderia invalidar o checksum registrado pelo Liquibase e impedir a inicialização da aplicação.
A correção foi implementada por meio de uma nova migração, executada após as anteriores, inclusive em instalações novas.

As orientações abaixo consideram a atualização da versão 1.18.2 para a 1.18.3. Caso o ambiente esteja em uma versão anterior, siga as orientações das releases intermediárias, partindo da versão atualmente instalada até chegar à versão 1.18.2.
- Parâmetros de configuração: esta versão não introduz novos parâmetros.
- FaaS: não é necessário atualizar o FaaS nesta versão.
- Migração de dados: a atualização aplica automaticamente o changeset 20260930-normalize-general-settings-legacy-arrays durante a inicialização da aplicação.
🐳 Imagens Docker
Utilize a imagem abaixo, conforme o ambiente:
Central IT
A migração normaliza a coluna general da tabela settings nos registros que contêm os formatos antigos de arrays. Os demais dados são preservados, e registros com JSON inválido são ignorados com a emissão de um aviso. Não é necessária nenhuma ação manual para executar a migração. Ambientes em que a coluna general já tenha sido corrigida manualmente não serão afetados, pois os valores que já estão no formato de objeto JSON simples permanecem inalterados.
Data: de publicação: 28/09/2026
Esta versão do Low Code Web traz melhorias na leitura e no gerenciamento das configurações gerais da plataforma, garantindo maior compatibilidade com dados de versões anteriores e mais confiabilidade na recuperação das configurações vigentes.

⚙️ Correção no carregamento das configurações gerais (Settings)
Corrigido o carregamento das configurações gerais da plataforma em ambientes que possuem dados gravados em formatos antigos. A atualização também garante que o sistema identifique corretamente o registro de configuração mais recente, evitando a utilização de informações desatualizadas.
O que foi corrigido:
- Compatibilidade com formatos antigos: o conversor GeneralSettingsConverter foi ajustado para reconhecer o formato legado utilizado por versões anteriores da plataforma. Quando identifica esse formato, o sistema extrai corretamente o objeto de configurações, permitindo a leitura dos dados existentes.
- Tratamento de configurações vazias: valores vazios, como [] e [null], passam a ser interpretados como ausência de configurações, sem provocar falhas durante o carregamento.
- Normalização dos dados no banco de dados: foi adicionada uma migração automática do Liquibase, identificada como 20260928-normalize-general-settings, que converte os registros armazenados no formato legado para o formato JSON simplificado. Registros com JSON inválido são ignorados durante essa migração e geram um aviso, sem interromper o processo.
- Seleção correta da configuração vigente: as consultas utilizadas para carregar e atualizar os Settings passaram a selecionar o registro ativo mais recente, utilizando a ordenação ORDER BY id DESC. Isso evita que ambientes com múltiplos registros antigos sem exclusão utilizem configurações desatualizadas.
- Ampliação dos testes automatizados: foram adicionados testes para validar a leitura de configurações no formato JSON simples, no formato legado, em formatos vazios e em situações com valores inválidos. Com isso, o comportamento do conversor é verificado em diferentes cenários.

As orientações abaixo consideram a atualização da versão 1.18.1 para a 1.18.2. Caso o ambiente esteja em uma versão anterior, siga as orientações das releases intermediárias, partindo da versão atualmente instalada até chegar à versão 1.18.1.
- Parâmetros de configuração: esta versão não introduz novos parâmetros de configuração.
- FaaS: não é necessário atualizar o FaaS nesta versão.
- Migração de dados: a atualização aplica automaticamente o changeset 20260928-normalize-general-settings durante a inicialização da aplicação.
🐳 Imagens Docker
Utilize a imagem abaixo, conforme o ambiente:
Central IT
A migração normaliza a coluna general da tabela settings somente nos registros armazenados no formato legado. Os demais dados são preservados, e registros com JSON inválido são ignorados com a emissão de um aviso.
Não é necessária nenhuma ação manual para executar a migração.
Data: de publicação: 24/09/2026
Esta versão do Low Code Web traz melhorias de segurança, desempenho e confiabilidade. As atualizações incluem novos controles para restringir componentes de fluxo, otimizações na execução de funções FaaS e correções no tratamento de datas e na conversão de atributos de objetos de negócio.

Veja abaixo as melhorias desta versão
🔐 Configuração para desabilitar componentes críticos de fluxo
Agora é possível desabilitar componentes específicos dos fluxos do Low Code por meio de uma configuração do ambiente, atendendo a instalações com requisitos de segurança mais rigorosos. Um exemplo é o Java Process Builder, que permite executar comandos no sistema operacional do servidor.
Essa evolução, originalmente disponibilizada na versão 1.17.1-STJ, passa a integrar a linha principal do produto a partir desta versão.
O que foi implementado:
- Novo parâmetro de configuração: foi criada uma variável de ambiente que permite informar quais tipos de componentes de fluxo devem ser desabilitados. A lista pode conter um ou mais componentes, separados por vírgula.
- Remoção dos componentes da paleta de criação: os componentes configurados deixam de aparecer na paleta do editor de fluxos ESI. Dessa forma, não podem ser adicionados durante a criação de novos fluxos nem em novas versões de fluxos existentes.
- Bloqueio dos componentes durante a execução: a restrição também se aplica aos fluxos já salvos ou importados que contenham componentes desabilitados. Ao identificar um desses componentes, o sistema interrompe a execução de forma controlada e registra o motivo no log de erro da instância. Assim, um componente desabilitado não pode continuar sendo executado indiretamente por meio de fluxos antigos ou importados.
- Mensagens de erro traduzidas: a mensagem apresentada quando uma execução é bloqueada respeita o idioma configurado na aplicação, com suporte a português, inglês e espanhol (pt/en/es).
- Configuração independente por ambiente: a lista de componentes desabilitados é carregada na inicialização da aplicação. Isso permite que cada ambiente ou cliente defina quais componentes podem ser utilizados, por meio de suas configurações de deployment.
Como configurar
A variável utiliza o nome do tipo do componente, correspondente ao nome simples da classe, e aceita vários valores separados por vírgula.
Para desabilitar o Java Process Builder, configure:
Para desabilitar mais de um componente, acrescente os nomes na mesma variável:
Comportamento padrão
Quando a variável não é informada ou está vazia, nenhum componente é desabilitado. Portanto, os ambientes existentes não precisam fazer alterações para manter o comportamento atual.
Observações importantes:
- A configuração é avaliada durante a inicialização da aplicação. Para aplicar alterações na lista, é necessário reiniciar a instância.
- O mesmo identificador é utilizado tanto para ocultar o componente na paleta quanto para bloquear sua execução. Isso garante que um componente indisponível na interface também seja impedido de executar.
⚡ Otimização do desempenho na execução de FaaS
Foi otimizado o processo de execução das funções FaaS, reduzindo o tempo necessário para preparar as chamadas HTTP e evitando o acúmulo de conexões não liberadas.
Antes dessa melhoria, cada execução de FaaS construía do zero o cliente HTTP utilizado para chamar o serviço. Essa preparação consumia aproximadamente 21 ms por execução. Além disso, a conexão HTTP criada a cada chamada não era liberada, fazendo com que os recursos se acumulassem ao longo do tempo.
O que foi implementado:
- Reutilização do cliente HTTP: o cliente HTTP passou a ser construído uma única vez e compartilhado entre as execuções, eliminando a necessidade de reconstruí-lo a cada chamada.
- Manutenção dos dados específicos de cada chamada: informações que variam entre as execuções, como o endereço do serviço e os cabeçalhos HTTP, continuam sendo definidas individualmente. Dessa forma, a otimização não altera o comportamento funcional das chamadas.
- Otimização da autenticação entre serviços: a mesma melhoria foi aplicada ao cliente HTTP utilizado na autenticação entre serviços, reduzindo também o custo de preparação dessas chamadas.
- Eliminação do acúmulo de conexões: com a mudança, deixa de ocorrer o acúmulo de conexões não liberadas a cada execução de FaaS, melhorando a utilização dos recursos da aplicação.
Resultados medidos:
- Tempo de montagem do cliente HTTP: reduziu de 21,2 ms para praticamente zero por execução.
- Tempo mínimo de ponta a ponta: a chamada POST /integrations/{name}/faas passou de 33,6 ms para 11,1 ms.
- Uso de recursos: eliminado o acúmulo de conexões não liberadas a cada execução de FaaS.

📅 Correção de datas e horários ao executar regras de negócio
Corrigido um problema que alterava indevidamente valores de data e hora durante a gravação de objetos de negócio que possuem regras de negócio associadas à inclusão ou alteração.
O que foi corrigido:
- Identificação correta dos campos de data e hora: os campos passam a ser identificados com base nos metadados do objeto de negócio. Isso contempla tanto as datas que a regra de negócio apenas repassa quanto aquelas que ela preenche ou modifica.
- Correção centralizada no momento da gravação: a restauração do tipo correto dos valores passou a ocorrer em um único ponto do processo de gravação, abrangendo operações de inclusão e alteração.
- Cobertura dos diferentes caminhos de gravação: a correção atende não apenas às operações realizadas por regras de negócio, mas também às gravações originadas por fluxos ESI e outros caminhos que recebam datas nesse formato.
- Preservação dos valores válidos: a conversão é aplicada somente aos valores que apresentam o formato afetado. Datas recebidas em outros formatos, como as enviadas pelas telas, e valores que já possuem o tipo correto são preservados sem alteração.
Atenção ao fuso horário da JVM
Não altere o fuso horário da JVM de um ambiente que já está em produção como tentativa de contornar esse problema. Em um ambiente configurado com UTC-3, mudar a JVM para UTC não é uma medida segura: os registros já gravados não são modificados, pois representam instantes absolutos, mas a exibição e as novas gravações podem sofrer deslocamentos devido às convenções utilizadas pelo sistema.
A padronização dos fusos em UTC está planejada para uma versão futura, juntamente com a normalização mais ampla do tratamento de datas.
Recomendação para novas instalações
Para novas instalações realizadas em um ambiente limpo, recomenda-se configurar a JVM em UTC desde o início, utilizando:
Essa recomendação é destinada a novas instalações e não deve ser aplicada como alteração de configuração durante a atualização de ambientes existentes.
🔄 Correção de falhas intermitentes na conversão de atributos
Corrigidas falhas intermitentes que ocorriam durante operações de leitura e gravação de objetos de negócio, relacionadas à conversão de atributos utilizados pela plataforma.
O que foi corrigido:
- Instância independente do conversor YAML: o YamlConverter passou a criar uma nova instância de Yaml a cada conversão, eliminando o compartilhamento de estado entre operações simultâneas.
- Proteção adicional no conversor de listas: a inicialização do ObjectMapper compartilhado no ListConverter também foi ajustada para ser segura em cenários de concorrência, prevenindo o mesmo tipo de problema.
- Testes automatizados de concorrência: foram adicionados testes que reproduzem a falha observada nas versões anteriores e verificam o comportamento esperado após a correção.
- Eliminação da necessidade de contornos nas aplicações consumidoras: com a correção aplicada diretamente na origem do problema, deixam de ser necessários os mecanismos de repetição de leitura e de serialização de gravações que algumas aplicações poderiam ter adotado para contornar as falhas.
Essas mudanças aumentam a confiabilidade das operações com objetos de negócio, reduzindo erros intermitentes causados pela execução simultânea de solicitações.

As orientações abaixo consideram a atualização da versão 1.18.0 para a 1.18.1. Caso o ambiente esteja em uma versão anterior, siga as orientações das releases intermediárias, partindo da versão atualmente instalada até chegar à versão 1.18.0.
- Migração de dados: esta versão não exige migração de dados.
- Atualização do FaaS: não é necessário atualizar o FaaS nesta versão.
- Fuso horário da JVM: não altere a configuração durante este deploy. Consulte as orientações da correção de datas e horários descrita nesta release.
🐳 Imagens Docker
Utilize a imagem abaixo, conforme o ambiente:
Central IT
🔐 Novo parâmetro de configuração de segurança
Antes de publicar em produção, revise se o ambiente precisa desabilitar algum componente de fluxo.
O parâmetro permite definir quais tipos de componentes devem ficar indisponíveis na paleta de criação e bloqueados durante a execução.
Configuração | Descrição |
|---|---|
app.security.flow.disabled-element-types | Parâmetro de configuração da aplicação que recebe os tipos de componentes a desabilitar. |
APP_SECURITY_FLOW_DISABLED_ELEMENT_TYPES | Nome da variável de ambiente correspondente, utilizado, por exemplo, em configurações do Kubernetes. |
Valor padrão | Lista vazia. Nenhum componente é desabilitado e o comportamento atual é preservado. |
Como definir a variável:
Informe os nomes dos tipos de componentes separados por vírgula. Por exemplo:
As variáveis de ambiente seguem as regras de binding relaxado do Spring Boot: os nomes são escritos em maiúsculas, os pontos são substituídos por _ e os hífens são removidos.
A configuração é carregada na inicialização da aplicação. Portanto, após alterar a lista de componentes desabilitados, reinicie a instância para que a mudança seja aplicada.
Data: de publicação: 10/06/2026
🚀 Atualizações do Low Code
Esta versão traz melhorias importantes em desempenho, monitoramento, integração e estabilidade da plataforma, tornando o ambiente mais eficiente e confiável.

📊 Monitoramento mais completo de execuções
O sistema passou a registrar informações mais detalhadas sobre execuções, incluindo consumo de memória, tempo de processamento, consultas realizadas e etapas executadas.
👉 Isso facilita a análise de desempenho e a identificação de possíveis gargalos.
🤖 Integração aprimorada com componentes gerados por IA
Foram adicionados novos recursos para gerenciamento e sincronização de formulários, objetos de negócio e regras.
👉 O processo de importação ficou mais simples, organizado e com melhor acompanhamento de status e erros.
🔎 Nova tela para análise de desempenho
Foi criada uma nova tela para consulta das execuções com maior consumo de recursos.
Agora é possível visualizar rapidamente:
- Tempo de processamento
- Consumo de memória
- Usuário responsável
- Origem da execução
- Status da operação
👉 Facilitando investigações e análises operacionais.
🔒 Melhor controle de inicialização em ambientes distribuídos
O processo de inicialização foi otimizado para ambientes com múltiplas instâncias da aplicação.
👉 Isso reduz processamento duplicado e melhora a estabilidade durante a subida do sistema.
🧹 Logs mais limpos e organizados
Foram reduzidas mensagens desnecessárias durante a compilação e inicialização da aplicação.
👉 Os registros ficaram mais claros e fáceis de analisar.
🔗 Relacionamento entre logs de execução
Agora execuções relacionadas podem ser conectadas entre si, permitindo acompanhar toda a cadeia de processamento de forma mais organizada.
👉 Isso facilita auditorias e diagnósticos.
🔐 Melhor desempenho dos endpoints seguros
Os endpoints protegidos receberam otimizações que reduzem consumo de memória e melhoram a velocidade de resposta.
Além disso:
- Respostas ficaram mais consistentes
- Tratamento de erros foi aprimorado
- Maior controle sobre respostas muito grandes
👉 Tudo isso mantendo os mesmos níveis de segurança.
⚡ Mais eficiência em consultas de objetos de negócio
As consultas originadas por integrações e fluxos passaram a consumir menos memória e registrar informações de execução de forma mais eficiente.
🚀 Otimização de relacionamentos em consultas
Melhorado o carregamento de relacionamentos em objetos de negócio.
👉 Consultas com grande volume de dados passaram a ter melhor desempenho.

🍪 Correção na geração de cookies de autenticação
Resolvido um problema que fazia o sistema gerar informações duplicadas relacionadas ao token de autenticação.
⚙️ Correção na execução de regras de negócio
Corrigido um erro que impedia a execução correta de determinadas regras acionadas por URL.
👉 As regras agora são localizadas e executadas corretamente.
📝 Correção na criação de versões de formulário
Ajustado um comportamento que criava novas versões de formulários mesmo quando nenhuma alteração havia sido realizada.
👉 Agora novas versões são geradas apenas quando realmente necessário.
🗂️ Correção na exclusão de abas de formulário
Resolvido um problema que impedia a remoção definitiva de abas no desenho de formulários.
👉 As alterações agora são salvas corretamente.
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.17.2 para a 1.18.0.
- Caso esse não seja o seu cenário, siga as Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a versão 1.17.2.
🐳 Imagens Docker
⚠️ Importante
Para que as implementações do card #13553 funcionem, é necessário atualizar o FaaS para a versão 1.7.0-RELEASE ou superior.
Novos parâmetros de configuração (revisar antes de produção):
As variáveis de ambiente (ex.: Kubernetes) seguem a binding relaxada do Spring Boot: nome em MAIÚSCULAS, pontos viram _ e hífens são removidos.
- app.queries.jwe-inline-max-bytes (env: APP_QUERIES_JWEINLINEMAXBYTES) — teto de tamanho da resposta JWE inline (padrão 32 MB).
- app.log.sql-metrics-enabled (env: APP_LOG_SQLMETRICSENABLED) / app.log.memory-profiling-enabled (env: APP_LOG_MEMORYPROFILINGENABLED) — instrumentação de log ligada por padrão (registra tempo decorrido, bytes alocados e SQL por execução). Mantida ativa; ajustável por ambiente.
Data: de publicação: 09/06/2026
Esta versão traz ajustes importantes para melhorar integrações, controle de acesso e consistência das informações no sistema.

- 📅 Correção no tratamento de campos de data.
Corrigido um problema que podia afetar o funcionamento de colunas do tipo data em objetos de negócio.
👉 Agora são processadas e exibidas de forma mais consistente, evitando erros e divergências nas informações.
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.17.1 para a 1.17.2.
- Caso esse não seja o seu cenário, siga as Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a versão 1.17.1.
🐳 Imagens Docker
Data: de publicação: 04/05/2026
Esta versão traz ajustes importantes para melhorar integrações, controle de acesso e consistência das informações no sistema.

- 🔗 Correção no retorno de relacionamentos em objetos de negócio
- Corrigido um problema onde o recurso de criar ou atualizar objetos de negócio createOrUpdate não retornava corretamente os dados relacionados.
- 🔐 Correção no controle de permissões do Core
- Ajustado um erro onde o sistema não estava respeitando corretamente as configurações de acesso definidas para funcionalidades do Core;
- A aplicação não estava obedecendo às configurações de:
- APP_SECURITY_COREFEATURES_ACCESSROLES_{IDENTIFICADOR DA FUNCIONALIDADE}
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.17.0 para a 1.17.1.
- Caso esse não seja o seu cenário, siga as Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a versão 1.17.0.
🐳 Imagens Docker
Data: de publicação: 10/04/2026

- 🚫 Controle de formulário via parâmetro
- Para páginas de formulário Low Code renderizadas via iframe, todos os controles do formulário são desabilitados quando for enviado o query param disabled=true
- ⚡ Atualização do AngularJS
- O sistema foi atualizado para uma versão mais recente NES v1.9.7, trazendo mais estabilidade e compatibilidade. Foi feito o tratamento de rejeição de promises e tratamento do .success no $http
- 📡 Novo modelo de carregamento de dados em tempo real
- Criado endpoint que retorna dados de objeto de negócio com SSE;
Foi adicionado o endpoint:
Que retorna dados de forma incremental via Server-Sent Events (SSE).
Funcionamento
- Executa a query em streaming direto do banco (ResultSet);
- Envia os dados em lotes dinâmicos baseados em tamanho (bytes), não por quantidade fixa de registros;
- Eventos suportados:
- start: início;
- data: lote de registros;
- end: finalização;
- error: erro ou limite excedido.
- O cancelamento ocorre automaticamente ao fechar a conexão (client abort).
- 🔗 Consumo de dados mais eficiente no front-end
- Adequado o SDK JavaScript para ler dados de objeto de negócio com SSE.
Foi adicionado o método listWithSse(params, onDataChunk) na classe BusinessObject do SDK, para consumo assíncrono do endpoint /{project}/{business-object}/sse via SSE.
Funcionamento
- O método usa a infraestrutura _getSse(...) do AxiosTransaction para abrir a conexão SSE e processar os eventos do backend;
- Os eventos data recebidos são acumulados em um array interno e a operação é concluída quando o evento end é recebido;
- Retorno do método:
- promise: resolve com os dados completos ao final
- abort(): encerra a conexão SSE manualmente
Recursos Adicionais
- Suporte opcional ao callback onDataChunk, executado a cada lote recebido;
- Controle de sequência dos eventos por lastEventId, com validação para evitar duplicidade ou quebra de ordem;
- Compatibilidade com ambiente com JWE habilitado, incluindo decrypt dos lotes quando necessário.
Benefícios
- Permite consumir consultas grandes de forma incremental no frontend;
- Reduz a necessidade de resposta única e imediata;
- Mantém suporte a cancelamento explícito da operação pelo cliente.
- 🔐 Mais tolerância de segurança no tempo de validação
- Aumentado o tempo de tolerância na validação de segurança, evitando erros por diferença de horário entre sistemas.
O valor default da variável APP_SECURITY_JWE_ANTIREPLAY_SKEWSECONDS foi alterado de 30 segundos para 300 segundos (5 minutos).
- Esse parâmetro define a margem de tolerância de tempo usada na validação do campo ts do payload JWE, permitindo pequenas diferenças de relógio entre cliente e servidor; fora dessa faixa, a mensagem é rejeitada com erro de timestamp inválido.
- 🆔 Geração de ID mais segura e rápida
- Melhorado mecanismo de geração de PK de objeto de negócio;
Foi adotado o JdbcTemplate para definição do valor de PK de objetos de negócio baseada em sequences.
A mudança trouxe melhorias imediatas:
- Fim dos vazamentos de conexão (abertura/fechamento seguro com o banco);
- Transações mais seguras (ID respeita a mesma transação; em rollback o ID não se perde “solto”);
- Consultas mais rápidas (sem depender de pré-compilação);
- Resolução facilitada (falhas viram exceções padronizadas, com suporte mais claro).
- 💬 Melhor controle ao restaurar tickets
Adicionados novos parâmetros que melhoram o controle de comentários e visualização ao restaurar tickets.
- Inclusão dos atributos commentMode e view na chamada ServiceRequestIncidentRepository.restoreRequest do dynamic-task-controller.js .
- ⏳ Controle de tempo nas integrações
Agora as integrações com ITSM possuem limite de tempo para resposta, evitando travamentos.
- Implementado timeout de conexão e response nas chamadas ao ITSM;
- Implementação de readTimeout e connectionTimeout nas integrações do Low Code com o ITSM.
- 🔌 Melhor uso de conexões com banco de dados
O sistema agora utiliza melhor as conexões com o banco, deixando tudo mais rápido e estável.
- Otimizado o uso de conexões nas operações BD de objeto de negócio;
- Melhoria nos métodos da classe DataManager para aproveitar ao máximo as conexões de banco de dados.

- 🆔 Correção no retorno de ID
- Corrigido erro onde, ao criar um registro em objeto de negócio, o sistema não retornava o PK gerado corretamente.
- 📊 Correção em grids de formulário
- Ajustado problema onde a grid padrão business-object-list não traziam corretamente os relacionamentos;
- 🧾 Correção ao salvar formulários
Resolvido erro que impedia o envio de formulários dentro do Centro de Experiencia em alguns cenários:
- Quando havia erro na configuração de template de formulários, o submit emitia erro no console e não efetivava a gravação.
- 🗄️ Correção na criação de estrutura no banco
Ajustado problema que impedia a aplicação de regras obrigatórias (campos obrigatórios) ao importar dados.
- O histórico de alterações de nulidade de colunas de tabelas de BD agora é criado na importação de pacotes;
- DDL de objeto de negócio com SET NOT NULL agora é executada.
- 📑 Correção em relatórios antigos
Corrigido erro em relatórios mais antigos que não estavam enviando todas as informações necessárias.
- Para relatórios criados nas primeiras versões da integração com Stimulsoft, variáveis não marcadas com “Viewer” agora são enviadas ao backend.
- 🌍 Correção de fuso horário (timezone)
Ajustado o tratamento de data e hora, garantindo que:
- horários sejam exibidos corretamente
- diferenças de fuso não causem erros
Foram revisadas e corrigidas consultas e atualizações de dados de objetos de negócio contendo timestamp (com e sem timezone):
- Ao carregar o formulário Low Code, o sistema armazena LOWCODE_CONFIG.timeZone e LOWCODE_CONFIG.utcOffset com base no cadastro do usuário no Frontmanager;
- Caso não existam, o sistema obtém timeZone e utcOffset do navegador;
- A cada requisição, o frontend envia nos headers:
- Time-Zone com LOWCODE_CONFIG.timeZone
- UTC-Offset com LOWCODE_CONFIG.utcOffset
- Foi criado o tipo de coluna Timestamp TZ, garantindo armazenamento consistente com time zone e offset:
- O backend converte para UTC considerando o time zone informado no header e grava como Timestamp UTC no banco;
- O tipo de coluna Datetime foi renomeado para Timestamp UTC:
- Para esse tipo, o backend recebe a data/hora do navegador e não faz conversão
- 🔽 Correção no campo de seleção múltipla
Corrigido problema no campo de seleção onde:
- não aparecia opção de remover item;
- não mostrava corretamente as descrições.
O componente input.select agora traz o ícone de exclusão e a descrição quando a propriedade “Seleção múltipla” está habilitada.
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.16.6 para a 1.17.0.
- Caso esse não seja o seu cenário, siga as Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a versão 1.16.6.
🐳 Imagens Docker
Data: de publicação: 01/03/2026

Agora a página da tarefa consegue buscar e carregar corretamente as informações da solicitação, sem perder dados ou ficar desatualizada.
- Recuperado $rootScope.request na página de tarefa.

🧩 Foram corrigidos:
- Corrigido um problema que impedia visualizar corretamente os registros (logs) de pacotes;
- Corrigido um erro que acontecia ao tentar apagar 1ª Variável do Fluxo de Integração do Low Code;
- Ajustado um problema em que os relatórios Stimulsoft não seguiam o idioma escolhido no Frontmanager;
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.16.3 ou 1.16.4 para a 1.16.6.
- Caso esse não seja o seu cenário, siga as orientações das Notas de Release anteriores, começando pela versão atualmente instalada no ambiente até alcançar a versão 1.16.3 ou 1.16.4.
🐳 Imagens Docker
Data: de publicação: 31/01/2026

🧩 Corrigido o erro no upload do repository de objeto de negócio
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.16.2 para a 1.16.3.
- Caso esse não seja o cenário, siga as orientações das Notas de Release anteriores, começando pela versão do ambiente até alcançar a versão 1.16.2.
🐳 Imagens Docker
Data: de publicação: 19/01/2026

Implementado multi-seleção e botão de ação na grid da diretiva business-object-list
- Ações globais aparecem na barra de ações do grid (por exemplo, ao lado do botão “Criar”). Elas podem operar sobre uma seleção múltipla (ex.: Exportar) ou não exigir seleção (ex.: Importar).

- Foram criadas as seguintes propriedades na diretiva business-object-list:
Propriedade | Tipo | Descrição | Uso prático |
|---|---|---|---|
is-checkbox | Boolean | Ativa a exibição de checkboxes no grid, permitindo a seleção de um ou mais registros. | Usar quando houver ações em lote, como exportação ou exclusão. |
checked-attribute | String | Define o atributo do item usado como identificador único da seleção. | Normalmente utiliza-se id ou uuid. |
selected-items | Array | Lista contendo apenas os identificadores dos itens selecionados. | Ideal para chamadas ao backend baseadas em IDs. |
selected-models | Array | Lista com os objetos completos dos registros selecionados. | Usado quando a ação precisa de mais dados do item. |
additional-actions | Array | Conjunto de ações globais customizadas exibidas na barra do grid. | Permite criar ações como Exportar, Importar e Processar. |
| | | |
- Estrutura de uma ação customizada utilizada em additionalActions, incluindo seus atributos e o contexto (ctx) recebido no callback onClick.
Atributo | Tipo | Descrição | Observações / Conteúdo |
|---|---|---|---|
label | String | Texto exibido para o usuário na ação. | Exemplo: 'Exportar', 'Importar', 'Processar'. |
icon | String | Classe CSS do ícone exibido junto ao rótulo da ação. | Normalmente utiliza classes do Font Awesome, ex.: 'fa fa-download'. |
requireSelection | Boolean | Indica se a ação exige pelo menos um item selecionado no grid. | Quando true, a ação só fica habilitada se houver seleção. |
onClick | Function | Função executada ao clicar na ação. | Recebe um objeto ctx com informações do grid e da seleção. |
ctx.selectedItems | Array | Lista dos identificadores (ex.: id ou uuid) dos itens selecionados. | Usa o atributo definido em checked-attribute. |
ctx.selectedModels | Array | Lista dos objetos completos selecionados no grid. | Evita a necessidade de nova consulta ao backend. |
ctx | Object | Contexto completo fornecido à ação. | Pode conter outros metadados do grid, dependendo da implementação. |
Exemplo de utilização no javascript:
Implementado botão de ação para cada item da grid da diretiva business-object-list
- Ações por linha aparecem junto de cada item do grid. Elas executam operações contextuais sobre um único registro, sem depender de seleção múltipla (ex.: abrir detalhes, duplicar, executar ação customizada).

- Foi criada a propriedade row-additional-actions na diretiva business-object-list, contendo o array de ações para cada item.
- Estrutura de uma ação customizada utilizada em rowAdditionalActions (row-additional-actions na diretiva), incluindo seus atributos e o contexto (ctx) recebido no callback onClick:
Atributo | Tipo | Descrição | Observações / Conteúdo |
|---|---|---|---|
label | String | Texto exibido para o usuário na ação. | Exemplo: 'Exportar', 'Importar', 'Processar'. |
icon | String | Classe CSS do ícone exibido junto ao rótulo da ação. | Normalmente utiliza classes do Font Awesome, ex.: 'fa fa-download'. |
onClick | Function | Função executada ao clicar na ação. | Recebe um objeto ctx com informações do grid e da seleção. |
visible | Function | Função que determina se a ação é visível. | Recebe um objeto ctx com informações do grid e da seleção. |
ctx.model | Object | Item selecionado. | |
ctx | Object | Contexto completo fornecido à ação. | Pode conter outros metadados do grid, dependendo da implementação. |
- Exemplo de utilização em JavaScript:
Tratar original Url com http ou https no envelope JWE
- Tratamento do atributo originalUrl do envelope JWE quando a URL já contém http/https ou o contexto do Low Code.

🧩 Corrigido a exibição do painel esquerdo da tela CRUD de projetos
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização esteja sendo realizada da versão 1.16.1 para a 1.16.2.
- Caso este não seja o seu cenário, siga as orientações das Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a 1.16.1, antes de aplicar esta atualização.
🐳 Imagens Docker
Data: de publicação: 08/01/2026

🧩 Tratamento de query parameters na página de tarefa Ajuste para tratar corretamente os parâmetros ticketId e workItemId na página de tarefa.
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização esteja sendo realizada da versão 1.16.0 → 1.16.1.
- Caso este não seja o cenário do ambiente, siga as orientações das Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a 1.16.0, antes de aplicar esta atualização.
🐳 Imagens Docker
- registry.cloud4biz.com/deployscdi/hyper-lowcode:1.16.1-RELEASE nexus.centralit.io:9091/hyper-lowcode:1.16.1-RELEASE
Data: de publicação: 31/12/2025 - Release Ref. Git-1.16.0

🔒Criptografia JWE de ponta a ponta
- Foi implementada criptografia ponta a ponta nas requisições entre frontend e API, utilizando o padrão JWE (RFC 7516).
- A partir desta versão, os dados deixam de trafegar em JSON aberto e passam a ser criptografados no cliente, sendo decriptados apenas pela aplicação de destino.
- A solução utiliza chaves públicas expostas via /.well-known/jwks.json, geração de chaves efêmeras por requisição e criptografia bidirecional (request/response), garantindo maior confidencialidade, integridade dos dados e segurança contra inspeção de payload.
Funcionamento resumido
- O backend disponibiliza sua chave pública por meio de um endpoint padrão /.well-known/jwks.json
- Antes de cada requisição, o frontend:
- 1 - Gera uma chave criptográfica efêmera (temporária).
- 2 - Monta um envelope contendo método, URL, payload, identificadores e metadados.
- 3 - Criptografa todo esse conteúdo usando JWE com a chave pública do servidor.
- A requisição é enviada contendo apenas:
- Um campo jwe, com o conteúdo criptografado.
- A chave pública efêmera do cliente, necessária para a resposta.

🧩SDK do Low Code e Stimulsoft com suporte a JWE
O SDK do Low Code é uma abstração da implementação do FaaS que pode ser utilizada no Javascript.
O SDK do Low Code passou a tratar criptografia JWE de forma transparente no consumo de:
- Objetos de Negócio
- Componentes Query
- FaaS
- ESI
Exemplos de utilização do SDK:


🔑 API Key para acesso à API
- Com a implementação da criptografia ponta a ponta nas requisições entre frontend e backend, os dados passaram a ser trafegados exclusivamente no padrão JWE (RFC 7516). Dessa forma, não é mais permitido o consumo da API do Low Code utilizando JSON aberto.
- Entretanto, a adoção desse modelo inviabiliza o acesso direto à API por clientes externos que não implementam JWE. Para atender esse cenário, foi criado um mecanismo de autenticação via API Key para os endpoints de Objetos de Negócio, Componentes Query, FaaS e ESI.
- A partir desta versão, os administradores devem criar uma ou mais API Keys por projeto e fornecê-las aos clientes que irão consumir a API do Low Code. A criação da API Key é realizada na tela de manutenção de projeto, e a chave é exibida apenas no momento da criação, em uma janela popup.
- Por motivos de segurança, a API Key não pode ser visualizada novamente após a criação. Portanto, é indispensável que a chave seja copiada e armazenada com segurança antes de ser compartilhada com o cliente.
Como criar uma API-Key ou X-API-Key


O Cadastro da API Key possui:
- Um Prefixo e sufixo utilizados para identificação;
- Uma data de expiração, permitindo controle do período de validade, e os acessos podem ser configurados de forma granular por tipo de recurso.
- Permissões granulares por tipo de recurso
Recursos com permissão configurável
É possível definir permissões específicas para os seguintes recursos:
- Objeto de Negócio: Leitura, Criação, Alteração, Exclusão
- Componente Query: Execução
- FaaS: Execução
- Fluxo (ESI): Execução

Uso da API Key
Para consumir os endpoints protegidos, o cliente deve informar a API Key no header da requisição REST, utilizando um dos seguintes nomes de cabeçalho:
O valor informado no header deve corresponder à API Key válida configurada no projeto. Requisições sem o header ou com chave inválida serão rejeitadas pela aplicação.
📁 CRUD de Projeto via API
A partir da versão 1.16.0, é possível:
- Listar;
- Criar;
- Alterar;
- Remover projetos através de API específica no Low Code.

📏 CRUD de Regra de Negócio via API
A partir da versão 1.16.0, é possível:
- Listar;
- Criar;
- Alterar;
- Remover regras de negócio através de API específica no Low Code.

🗂️ CRUD de Objeto de Negócio via API
A partir da versão 1.16.0, é possível:
- Listar;
- Criar;
- Alterar;
- Remover o objetos de negócio através de API específica no Low Code.

🔍 Endpoint para SQL SELECT
Foi criado o endpoint para execução de SQLs de SELECT de objeto de negócio:

✏️ Endpoint para SQL UPDATE/DELETE
Foi criado o endpoint para execução de SQLs de UPDATE e DELETE de objeto de negócio:

📝Templates ITSM em Formulários
Foi disponibilizada uma opção no cadastro de formulários para criar templates de portfólio no ITSM.
Essa opção só está disponível se a variável de ambiente abaixo estiver parametrizada:


✅ Permissão de CRUD via API Key
Através da propriedade “API de cadastro” o registro de API Key na tela de gerenciamento de projetos permite habilitar ou desabilitar o acesso aos endpoints de:
- CRUD de projeto;
- Regra de negócio;
- Objeto de negócio.

🖼️Imagens
🚀ORIENTAÇÕES PARA DEPLOY
Este documento pressupõe que a atualização está sendo feita da versão 1.15.x para a 1.16.0. Caso esse não seja o cenário, siga as orientações das Notas de Release anteriores, começando pela versão do ambiente até alcançar a versão 1.15.x.
Para a correta utilização dos recursos de criptografia ponta a ponta (JWE) e API Key, é obrigatório configurar previamente as variáveis de ambiente relacionadas à segurança da aplicação.
⚠️ Importante
A aplicação não inicializa sem a configuração correta das variáveis de segurança.
🔐Configuração de API Key
A partir desta versão, o acesso aos endpoints de Objetos de Negócio, Componentes Query, FaaS e ESI por clientes externos requer o uso de API Key, quando a criptografia JWE estiver habilitada.
As seguintes variáveis de ambiente devem ser configuradas
- Alterar o PEPPER invalida todas as API Keys existentes.
🔒Configuração de Criptografia JWE
Quando habilitada, a criptografia JWE passa a ser obrigatória para todas as requisições entre frontend e backend.
As seguintes variáveis de ambiente devem ser configuradas:
⚠️ OBSERVAÇÕES IMPORTANTES
- Todas as chaves e valores sensíveis devem ser armazenados de forma segura (ex.: secrets manager, variáveis de ambiente protegidas).
- Alterações em chaves criptográficas ou API Keys podem impactar integrações existentes.
- Recomenda-se planejar a rotação de chaves utilizando múltiplos kids durante períodos de transição.
- Sem a configuração correta dessas variáveis, a aplicação não inicializará corretamente.
Exemplo de configuração:
🛠️ Utilização do Gerador de Configuração de Segurança
Para facilitar a configuração das variáveis de ambiente relacionadas à API Key e à criptografia ponta a ponta (JWE), foi disponibilizado o utilitário:
Ele está disponível no https://nexus.centralit.io atualmente na versão 1.0.2:

Este utilitário deve ser executado durante o processo de implantação da aplicação, gerando automaticamente as chaves criptográficas e os valores necessários para configuração dos ambientes.
➡️ Execução
A execução do gerador requer Java JRE 11 ou superior, e pode ser feita de duas formas:
- Em máquina local, por meio do comando:
- Em container, por meio do comando:
O parâmetro optional-key-name é opcional e pode ser utilizado apenas para identificação do contexto de geração. Ao ser executado, o utilitário retorna as variáveis de ambiente para configuração dos containers:
· Configuração de segurança do Low Code (JWE e API Key);
· Chave X-Api-Key para ITSM, Events, Agility backend e FaaS.
Essas variáveis podem ser copiadas diretamente para a definição do container ou para o gerenciador de secrets utilizado no ambiente:
- Low Code
- ITSM
- Events
- Agility Backend
- FaaS (ConfigMap)
⚠️ OBSERVAÇÕES IMPORTANTES
- As chaves geradas contêm informações sensíveis e devem ser armazenadas de forma segura.
- Recomenda-se executar o gerador sempre que houver necessidade de rotação de chaves ou criação de uma nova configuração de segurança.
✅ Compatibilidade de versões e configuração dos serviços integrados
Para o correto funcionamento da autenticação via API Key e da criptografia ponta a ponta (JWE), é obrigatório que os serviços integrados estejam nas seguintes versões mínimas:
Serviço | Versão mínima |
|---|---|
ITSM | 1.9.20 |
Events | 1.4.0 |
Agility Frontend | 1.2.2 |
Agility Backend | 1.9.1 |
FaaS | 1.5.0 |
Além da compatibilidade de versão, os serviços FaaS, Events e ITSM devem ser configurados para utilizar a API Key do Low Code, gerada pelo utilitário security-config-generator.
- Configuração no ITSM
O ITSM deve receber a API Key por meio da seguinte variável de ambiente:
- Configuração no Events
O Events deve receber a API Key por meio da seguinte variável de ambiente:
- Configuração no Agility backend
O Agility backend deve receber a API Key por meio da seguinte variável de ambiente:
- Configuração no FaaS
O FaaS deve ser configurado com a API Key no arquivo ConfigMap:
Onde <API_KEY_MASTER> corresponde ao valor gerado pelo security-config-generator e utilizado para autenticação entre os serviços.
⚠️ OBSERVAÇÕES IMPORTANTES
- A API Key configurada nesses serviços deve ser a mesma utilizada pelo Low Code.
- A ausência ou configuração incorreta dessas variáveis resulta em falhas de autenticação e indisponibilidade das integrações.
- Recomenda-se validar essas configurações após o deploy, antes da liberação do ambiente para uso.
Data: de publicação: 08/01/2026

🧩 Tratamento de query parameters na página de tarefa Ajuste para tratar corretamente os parâmetros ticketId e workItemId na página de tarefa.
⚙ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização esteja sendo realizada da versão 1.15.4 → 1.15.5.
- Caso este não seja o cenário do ambiente, siga as orientações das Notas de Release anteriores, partindo da versão atualmente instalada até alcançar a 1.15.4, antes de aplicar esta atualização.
🐳 Imagens Docker
- registry.cloud4biz.com/deployscdi/hyper-lowcode:1.15.5-RELEASE
- nexus.centralit.io:9091/hyper-lowcode:1.15.5-RELEASE
Data: de publicação: 30/12/2025 - Release Ref. Git-1.15.4

🧩 SQL mais esperto Corrigido um erro que fazia o sistema entender errado os tipos de parâmetros usados nos SQLs dos objetos de negócio.
🗂️ Atualização sem erro Ajustado um problema que causava falha na leitura do DDL (estrutura do banco) na hora de atualizar um objeto de negócio.
🚀ORIENTAÇÕES PARA DEPLOY
- Este documento pressupõe que a atualização está sendo feita da versão 1.15.1, 1.15.2 ou 1.15.3 para a 1.15.4. Caso esse não seja o cenário, siga as orientações das Notas de Release anteriores, começando pela versão do ambiente até alcançar a versão 1.15.1, 1.15.2 ou 1.15.3.
🖼️Imagens
- Nexus: nexus.centralit.io:9091/hyper-lowcode:1.15.4-RELEASE
- Portus: registry.cloud4biz.com/deployscdi/hyper-lowcode:1.15.4-RELEASE
Data: de publicação: 19/12/2025 - Release Ref. Git-1.15.3

🛠️ Correções importantes
- 🗓️ Campo de data corrigido O campo datasearch agora não aceita mais datas inválidas, evitando erros inesperados.
- 🚨 Tela de erro de instalação melhorada Agora a tela mostra:
- 📄 Detalhes do erro (stack trace)
- 🔄 Botão para atualizar a página 👉 Facilita muito identificar e resolver problemas.
- 🔗 Relacionamentos de dados corrigidos O sistema voltou a buscar corretamente os relacionamentos dos objetos de negócio.
- 🧩 SQL mais flexível Corrigido o erro que obrigava tipar parâmetros no SQL. Agora o parse funciona corretamente sem ajustes manuais.
- ⏰ Componente de data e hora ajustado Corrigido o erro de renderização do campo Date Time nos formulários.
Data: de publicação: 16/12/2025 - Release Ref. Git-1.15.2

🔍 Campo de busca mais eficiente O campo datasearch agora só aceita valores válidos, evitando erros e resultados estranhos.
⚠️ Tela de erro mais clara Quando dá problema na instalação, a tela de erro agora:
- Mostra o erro completo (stack trace)
- Tem um botão para atualizar e tentar novamente
🔗 Relacionamentos funcionando corretamente Foi corrigido um erro que impedia a recuperação correta dos relacionamentos dos objetos de negócio.
🧾 SQL mais flexível O sistema agora interpreta melhor os parâmetros SQL dos objetos de negócio, sem obrigar você a definir a tipagem direto no SQL.
Data: de publicação: 22/11/2025 - Release Ref. Git-1.15.1

- Adicionado um novo meio para tratar acesso de formulários públicos no caso de URL inválida

- Resolvido um problema no componente query
- Corrigido um erro de base de dados na etapa de configuração de database
- Corrigido o erro "Could not determine data type of parameter" nas tabelas de objeto de negócio
- Corrigido um erro na importação de pacotes pela API
Data: de publicação: 18/10/2025 - Release Ref. Git-1.15.0

Reformulação tela do FaaS replicando tela Regras de Negócio A tela do FaaS agora segue a mesma identidade visual da nova tela do fluxo, mantendo as mesmas funcionalidades e regras de negócio. | ![]() |
|---|---|
Tela de debug - experiência mais fluida Agora, a tela de debug do fluxo também pode ser acessada durante a criação/edição de um fluxo, permitindo debugar o processo durante a criação do próprio fluxo. Juntamente com essa alteração, a tela de debug foi reformulada para ter a mesma identidade visual do novo fluxo e facilitar a utilização. | ![]() |
Tela de scripts ESI expandida O espaço ocupado pela tela de scripts dos Componentes ESI foi expandido, para facilitar a visualização. | |
Botão limpar - CRUD Agora é possível esconder o botão Limpar no popup de CRUD | |
Adequação na autenticação de recursos públicos para keycloak 26 Para resolver um problema de compatibilidade com a versão 26 do keycloak, foi retirado o atributo ‘realm’ da tela de parâmetros de autenticação para URL pública. A partir dessa versão, o campo URL de autenticação da aba Segurança da página SETTINGS deve ser preenchido de forma completa. | ![]() |
Importação de pacotes reformulada O “execute-ddl” da importação de pacotes passou a ser string e o sistema agora faz um parse seguro para Boolean | |
Identificar URL de origem e Referer no Log Agora o sistema identifica o uuid do log, a URL de origem completa e o Referer da requisição, facilitando a identificação da origem de erros e avisos. | Exemplo: 2025-10-18 14:34:44.191 [0;39m [33mb337f6fe-a300-426f-a3b1-f78b9570b0da WARN http://localhost:8081/lowcode/rest/dynamic/petshop/pet/getPage - Referer: http://localhost:8081/lowcode/form/pet/crud [0;39m |
Ajustes na tela do novo fluxo A tela de fluxo agora possui mais funcionalidades para facilitar seu uso. | Adicionar scroll no diagrama para garantir visibilidade correta quando o fluxo for editado em resoluções mais altas ![]() Adicionar título nas abas do menu lateral da esquerda ![]() Permitir fechar o menu lateral da esquerda totalmente. ![]() |
Melhorias no cache de conexões dinâmicas e otimização do uso de memória O mecanismo de cache de conexões dinâmicas foi totalmente refatorado para aprimorar desempenho e estabilidade. As principais melhorias incluem: |
|
Todos os endpoints de listagem de registros de objetos de negócio sem paginação e listagem de componentes query foram refatorados para uso mais eficiente de memória. |
|
A otimização nesses endpoints envolve: |
|
Form-builder simplificada Agora a diretiva form-builder pode ser utilizada sem autenticação. | |
Divergências de data corrigidas Foi corrigida a divergência de timezone entre o Frontmanager e o backend do Low Code, que causava exibição incorreta (um dia a menos) nas datas dos formulários. |
|
Evolução nos cabeçalhos HTML Foi incluída a aba Header HTML na criação de páginas. Agora é possível incluir e parametrizar tags Open Graph usando uma lista padrão pré-definida. A propriedade og:url é retornada com o valor {{ autoCurrentUrl }} que se for mantido irá recuperar automaticamente o caminho da página. Este valor pode ser alterado para outra URL de interesse. | ![]() |
Criação de endpoint para exibir configuração do ambiente A URL ... /lowcode/env retorna informações de configuração da JVM e Time Zone. | {
"JAVA_TOOL_OPTIONS": "-XX:+UseG1GC -XX:MaxGCPauseMillis=200 -XX:+UseStringDeduplication -XX:MaxMetaspaceSize=512m -Xms2048m -XX:MaxRAMPercentage=70.0 -XX:+AlwaysPreTouch",
"tz": {
"jvm.zoneId": "GMT",
"jvm.timeZoneId": "GMT",
"sysprop.user.timezone": "GMT",
"db.session.timezone": "GMT",
"headers.Time-Zone": "GMT",
"headers.UTC-Offset": "+00:00",
"headers.UTC-Offset-Minutes": "0",
"now.instant": "2025-10-18T15:11:45.433084Z",
"now.zoned.jvm": "2025-10-18T15:11:45.433084Z[GMT]",
"now.zoned.header": "2025-10-18T15:11:45.433084Z[GMT]"
},
"jvm.inputArguments": [
"-XX:+UseG1GC",
"-XX:MaxGCPauseMillis=200",
"-XX:+UseStringDeduplication",
"-XX:MaxMetaspaceSize=512m",
"-Xms2048m",
"-XX:MaxRAMPercentage=70.0",
"-XX:+AlwaysPreTouch"
]
} |

Correções |
|---|
Corrigir duplicação de nomes de widgets na inclusão de componente Custom no form |
Não exibe desenho do fluxo no modo debug |
Cadastros do projeto abertos numa aba do browser influenciam em outra aba |
Alterações de coluna e chave de objeto de negócio sumindo da relação de DDL |
A importação de pacote lowcode não esta salvando a DDL de views. |
Erro na validação de ícone do fluxo ESI |
Não atualiza o status de execução de ESI no log |
Correção no Fluxo ao abrir através da tela de projetos |
A listagem paginada do objeto de negócio não respeita as colunas qdo isForGrid = true |
Erro no objeto de negocios, para o valor default no campo. LowCode |
Correção do parse de arquivos de ECM no componente ESI de email |
Os erros de alguns controllers não são capturados no log |
Revisar labels em inglês |
Corrigir fechamento de resultSet em métodos que checam existência de tabela |
Erro de cast na execução de SQL de objeto de negócio |
Chegaram novidades incríveis para deixar seu uso ainda mais simples, seguro e flexível! Uma atualização que reforça a missão da nossa área de Produto: gerar valor real, com entregas tangíveis que impulsionam a performance dos times e a eficiência operacional da plataforma. Confira abaixo o que mudou |
|---|
Data: de publicação: 01/07/2025 - Release Ref. Git-1.14.0

✨ 1) Fluxos ESI com visual melhor O desenho dos fluxos ficou mais claro e organizado — agora é mais fácil entender o que cada etapa faz. 🧩 | ![]() |
|---|---|
✨ 2) E-mail do ESI mais flexível Agora dá pra usar variáveis no código da caixa de e-mail (UUID). Isso ajuda a reaproveitar configurações em cenários diferentes. 🛠️📧 | ![]() |
✨ 3) Sem e-mail repetido O sistema bloqueia destinatários duplicados no envio de e-mails do ESI. Menos retrabalho e nada de mensagens em duplicidade. 🚫📨 | ![]() |
✨ 4) Relatórios mais leves no design No construtor de relatórios (Stimulsoft) você pode limitar quantas linhas o sistema traz só no modo de design:
| ![]() |
Essas melhorias elevam a experiência de uso, reduzem tempo e contribuem diretamente para melhor fluidez nos processos de gestão e operação. |
|---|

✔️ UUID do e-mail no ESI Consertado um erro que atrapalhava a leitura do código (UUID) da caixa de e-mail no componente ESI. Tudo certo agora. ✅ |
|---|
Data: de publicação: 03/06/2025

✨ 1. Acesso sem login (URL Pública) Agora é possível abrir certas páginas sem precisar fazer login. 🔒 Pode ser de 3 jeitos:
👉 1.1 - Caso esteja com o valor Anonymous ou All, a aba de segurança vai exibir a opção “Acesso público sem autenticação” 👉 1.2 - Por padrão, o sistema ainda bloqueia acesso público. Só libera se for configurado no projeto. | 👉 1.1 - ![]() 👉 1.2 - ![]() |
|---|---|
✨ 2. Permissões para acesso sem login ⚙️ Se você escolher a opção "Acesso público definido no projeto”, o sistema permite configurar as permissões para acesso anônimo.
| ![]() |
✨ 3. Novo Campo “Descrição” obrigatório 📝 Em colunas de objetos de negócio, agora tem um campo de descrição. ➡️ Precisa ter pelo menos 2 palavras e 5 caracteres. | ![]() |
✨ 4. Novo campo “Tags Autocomplete” nos formulários 🏷️ Foi criado um componente que deixa você escolher várias tags (como palavras-chave) em formulários. Ele permite a seleção de um ou mais valores através de um método de busca . | ![]() |
✨ 5. Melhor controle em versões 📦 Quando o sistema busca informações de um projeto (deployment), agora ele leva em conta a versão certa e o local (tenant). ➡️ Isso evita erros e registros duplicados. | ✨ 6. Nome “payload” proibido 🚫 Para evitar problemas técnicos, não dá mais pra usar o nome payload em cadastros de negócio. |

✔️ Ajustado um problema de bloqueio em tabelas internas; |
|---|
✔️ Corrigido erro na interpretação de variáveis em relatórios (Stimulsoft). |
Data: de publicação: 14/05/2025

🌐 Acesso Público Mais Inteligente Agora você pode liberar páginas sem exigir login! 💡 Uma nova configuração permite escolher como esse acesso será feito:
Além disso, ao ativar o acesso sem login, aparece no projeto a opção "Acesso público sem autenticação" para facilitar. | ![]() ![]() |
|---|---|
🛡️ Acesso público com segurança Se um recurso estiver liberado para uso público, você pode agora configurar quais ações podem ser feitas por quem não está logado. | ![]() |
📝 Descrição de colunas Na hora de criar campos no seu banco de dados, agora é obrigatório preencher o campo “Descrição” com pelo menos duas palavrinhas. Isso ajuda todos a entenderem melhor para que serve aquele campo. | ![]() |
🏷️ Novo campo de seleção com Tags Criamos um novo componente chamado Tags Autocomplete para formulários! 🔍 Ele permite escolher uma ou várias opções com busca inteligente, super prático! | ![]() |
🧩 Evitando duplicações Agora o sistema verifica melhor as versões e os ambientes em uso, evitando confusões com registros duplicados quando existem várias empresas usando o mesmo banco de dados. | ❌ Fim dos conflitos com o nome "payload" Para evitar problemas internos, agora o sistema não permite mais usar o nome “payload” em campos de dados. Isso ajuda a manter tudo funcionando direitinho. |

✔️ Corrigido problema de travamento em uma tabela específica ; |
|---|
✔️ Corrigido erro ao lidar com listas de dados em relatórios . |
Data de Publicação: 04/04/2025
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- Restringir acesso às funcionalidades do core do sistema.
✅ CORREÇÕES
- Não traz views materializadas na conexão de Banco de Dados;
- Não atualiza o usuário quando faz redirecionamento keycloak usando Chrome;
- Correção do acesso de formulários Low Code no ITSM.
Data de Publicação: 18/03/2025
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
• 7975 - Restringir acesso às funcionalidades do core do sistema
🚀ORIENTAÇÕES PARA DEPLOY
A partir desta versão 1.11.0-RELEASE, o usuário só consegue acessar as funcionalidades do core do Low Code se o token de autenticação contiver uma ou mais roles, que podem ser definidas na configuração do sistema das seguintes formas:
- Configurando uma ou mais roles padrão para acesso a todas as funcionalidades do core: APP_SECURITY_COREACCESSROLES_DEFAULT: {nome da role 1}, {nome da role 2}, ... {nome da role n} O sistema já vem configurado com a role padrão "lowcode_core" na variável APP_SECURITY_COREACCESSROLES_DEFAULT. Ou seja, caso essa configuração não seja alterada, a partir da versão 1.11.0-RELEASE, o token do usuário deverá conter a role "lowcode_core" para que ele possa acessar as funcionalidades do core do sistema.
- Configurando uma ou mais roles padrão para acesso a funcionalidades específicas do core: APP_SECURITY_COREACCESSROLES_{identificador da funcionalidade}: {nome da role 1}, {nome da role 2}, ... {nome da role n} Por exemplo, para configurar a role hyp_admin para acesso à funcionalidade de gerenciamento de projetos: APP_SECURITY_COREACCESSROLES_PROJECT_MANAGER: hyp_admin Estes são os identificadores das funcionalidades disponíveis: BUSINESS_OBJECT, BUSINESS_RULE_DESIGN, COMPONENT, COMPONENT_PROPERTY, CSS, DATABASE, DATABASE_CONNECTION, DATA_MODELING, DATA_TYPE, DOMAIN, FAAS, FLOW, FORM, HTML_PAGE, I18N, IMAGE, JAVASCRIPT, LOG, PACKAGE, PAGE_CONFIG, PARAMETER, PROJECT_MANAGER, QUERY_COMPONENT, REPORT_CONFIG, REPORT_FILE, SETTINGS, SNIPPET.
⚠️ Importante:
Por razões óbvias de segurança, é fortemente recomendado manter pelo menos uma role padrão configurada na variável APP_SECURITY_COREACCESSROLES_DEFAULT. No entanto, em casos excepcionais, esse controle pode ser desativado atribuindo "" a essa variável. Este documento pressupõe que a atualização está sendo feita da versão 1.10.1 para a 1.11.0. Caso esse não seja o cenário, siga as orientações das Notas de Release anteriores, começando pela versão do ambiente até alcançar a versão 1.10.1.
Data de Publicação: 11/03/2025
✅ CORREÇÕES
- 7934 - Correção da internacionalização do lowcode
- 7984 - Correção da exibição "Trial" na visualização de relatórios Stimulsoft
🚀ORIENTAÇÕES PARA DEPLOY
Este documento pressupõe que a mudança de versão está partindo da versão 1.10.1 para a 1.10.1. Caso não seja esse o cenário, siga as orientações das Notas de Release anteriores, partindo da versão do ambiente até a versão 1.10.1.
Data de Publicação: 05/03/2025
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 6589 - [17642] Integração da ferramenta Stimulsoft;
- 7889 - Permitir a autenticação externa keycloak e atualizaçao do token
- 7953 - Implementar importação e exportação de relatórios Stimulsoft
- 7954 - Restringir acesso a relatórios por roles;
✅ CORREÇÕES
- 7908 - Erro no tratamento de objetos JSON no componente ESI REST;
- 7958 - Erro na inclusão de objetos de negócio no package
🚀ORIENTAÇÕES PARA DEPLOY
Este documento pressupõe que a mudança de versão está partindo da versão 1.10.0 para a 1.10.0. Caso não seja esse o cenário, siga as orientações das Notas de Release anteriores, partindo da versão do ambiente até a versão 1.10.0.
Data de Publicação: 14/02/2025
✅ CORREÇÕES
- 7861 - Não está trazendo os labels de projeto
🚀ORIENTAÇÕES PARA DEPLOY
Este documento pressupõe que a mudança de versão está partindo da versão 1.9.0 para a 1.9.1. Caso não seja esse o cenário, siga as orientações das Notas de Release anteriores, partindo da versão do ambiente até a versão 1.9.0.
Data de Publicação: 17/01/2025
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 7548 - Extração dos fontes .html, .css e .js de um pacote para criação de projeto externo
- Implementação do botão “Código fonte” no CRUD de pacotes
- Ao clicar nesse botão, o sistema gera um .zip com todos os .css, .html, .js e imagens do pacote
- 7602 - Conversão do LowcodeSDK do FaaS para funcionar em .js no runtime do Low Code
- O LowcodeSDK do FaaS está disponível no frontend do Low Code. É só chamar “SDK” ao invés de “LowcodeSDK” e retirar o FaaS.lowcodeHttpConfig da criação dos objetos
- Importante ressaltar que não existe qualquer referência à classe FaaS. As variáveis e objetos devem ser tratados como Javascript puro que roda no browser
✅ CORREÇÕES
- 7644 - Validar se existe código antes de salvar um FaaS
- 7662 - Correção do path app-builder
- 7655 - Erro no componente de form input.select
- 7658 - Correção da identificação do path dos recursos quando a URL é /lowcode/lowcode
- 7663 - Configuração dos .jsp para UTF-8
Data de Publicação: 20/12/2024
✅ CORREÇÕES
- Erro na execução de regra de negócio do tipo Node.js.
Data de Publicação: 18/12/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 7512 - Forçar carga de imagens qdo o bucket MinIO está vazio
- 7497 - Criação de novos componentes ESI
- 7495 - Retirar propriedade de timeout na execução de FaaS
✅ CORREÇÕES
- 7507 - Erro na integração Low Code x ITSM em ambiente de desenvolvimento
- 7496 - Correção da importação de pacote com componente ESI de email
🚀ORIENTAÇÕES PARA DEPLOY
Este documento pressupõe que a mudança de versão está partindo da versão 1.8.6 para a 1.8.7. Caso não seja esse o cenário, siga as orientações das Notas de Release anteriores, partindo da versão do ambiente até a versão 1.8.6.
Data de Publicação: 06/12/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 7282 - Permitir acesso à página SPA sem configuração de acesso público
- 7405 - Melhoria na tela de acompanhamento da instalação
- 7406 - Adicionar qrcode na página de projeto para mobile
✅ CORREÇÕES
- 7335 - Componentes de formulário depreciados da versão 9 não são importados no lowcode
- 7343 - HTMLs de páginas 'task' e 'default' migrados da versão 9 não são renderizados corretamente
- 7345 - Erro na cláusula REFERENCES na DDL de relacionamentos de objeto de negócio
- 7283 - Correção da renderização de página HTML
- 7404 - Erro na importação de recursos CSS, mesmo marcando opção a opção replace
- 7322 - Erro "Page configuration 'null' is undefined for the form..." na importação de pacotes
Data de Publicação: 06/12/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 7324 - Voltar para tela de edição após debug do FaaS
✅ CORREÇÕES
- 7322 - Erro "Page configuration 'null' is undefined for the form..." na importação de pacotes
- 7323 - Erro na edição de pacote recém-criado
Data de Publicação: 08/10/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- Refactory na estrutura de forms para melhoria na performance de importação de pacotes
- Refactory na estrutura de objetos de negócio para melhoria na performance de importação de pacotes
- Refactory na execução da DDL de forma assincrona, com gravação de logs
- Também é possível ver o histórico de importação do pacote. Na tela principal, foi disponibilizado um botão de consultar log:
- Ao clicar no botão, é exibido o histórico de importação, sendo possível filtrar por data, usuário e IP de origem:
- Ao clicar na ação detalhar, o sistema exibe um tela com a identificação da importação e a relação dos objetos importados:
- Permitir a inclusão de recursos javascript do Low Code como dependências do FaaS
- Também é possível adicionar dependências diretamente no código através da classe FaaS.Util:
- Enviar mensagem websocket no log-trace do fluxo ESI
- Quando a rastreabilidade do fluxo ESI está ativada, o sistema exibe o canal web socket que permite a interação com a execução do fluxo:
- Através do componente Trace Log é possível enviar mensagens ao web socket:
- Para exibir as mensagens capturada do web socket, basta utilizar o método subscribeToWs no formulário Low Code:

✅ CORREÇÕES
- Atualização de itens do projeto no pacote não salva no BD
- Mensagem indevida de alteração por outro usuário na gravação de objeto de negócio
- Correção de defeitos na criação de form CRUD no cadastro de objetos de negócio
Data de Publicação: 11/09/2024
✅ CORREÇÕES
- 6527 - Correção da injeção de dependência FaaS
- Os formulários Low Code com dependências “FaaS” não funcionavam no ambiente ITSM
- 6530 - Correção da funcionalidade data modeling
Data de Publicação: 15/08/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 5605 - Permitir a criação de componentes dinâmicos de fluxo ESI
- Foi criada uma opção para definir se o fluxo ESI aparece como componente para criação de outros fluxos. Se essa opção for marcada, o usuário deve selecionar o grupo e a imagem que vai aparecer na paleta
- O fluxo se torna um componente da paleta e as variáveis marcadas como obrigatórias aparecem para configuração
- 5712 - Criar tipo de fluxo "Agente"
- Um agente é um fluxo ESI que é iniciado de forma manual ou na subida do sistema e roda indefinidamente, conforme definido no seu design.
- Para configurar um fluxo ESI como agente, basta marcar a opção “Deploy como agente” e definir se ele deve ser iniciado na subida do sistema ou de forma manual:
- Para que o agente seja executado, é necessário configurar a autenticação na funcionalidade .../lowcode/page/settings:
- Foi criada a funcionalidade para monitoração de agentes, que possibilita o deploy/ undeploy do agente e a visualização de logs:
- 6017 - [Ticket - 17077] - Melhorias FaaS
- Foi desenvolvida uma nova interface Javascript para integração com a versão 1.3.0-RELEASE do FaaS. Segue alguns exemplos de código: Executar um FaaS no front end:
🚀ORIENTAÇÕES PARA DEPLOY
- O FaaS deve ser atualizado para a versão 1.3.0-RELEASE ou superior
- Deve ser criada uma URL externa para utilização do FaaS no frontend. Essa URL não depende de tenant, não pode passar pelo frontmanager e deve apontar diretamente para a porta 3000 do FaaS no container, sem contexto. Exemplo: https://democentralit-node-faas.cithyper.click
- No configmap do Low Code, deve ser criada a variável de ambiente FAASCLIENT_DEFAULTCONNECTION_FRONTENDURL apontando para a URL externa do FaaS criada no item 2
⚠️ OBSERVAÇÕES:
Data de Publicação: 23/07/2024
✅ CORREÇÕES
- 6101 - Botão atualizar versão dos elementos no pacote não atualiza a versão na tela
- 6108 - Botão incluir página de formulário está abrindo tela de salvar
Data de Publicação: 18/07/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 5868 - Melhorias na funcionalidade de salvar o formulário na mesma versão e nova versão
- Foi acrescentado um terceiro número na versão (patch). Sempre que o usuário salvar o formulário na mesma versão, o patch é incrementado e a versão anterior é preservada.
- Foi criada uma funcionalidade para comparar código Javascript e HTML de versões diferentes do formulário.
- Quando o usuário seleciona a versão para comparar, o sistema exibe os locais onde há diferença de código e o usuário pode clicar para visualizar as diferenças.
- Ao clicar para visualizar as diferenças, o usuário pode fazer merge de código com a versão anterior.
- No caso do desenho da tela, o sistema exibe as diferenças de HTML mas não é possível fazer merge de componentes visuais.
- Ao salvar o formulário e quando houver alterações por parte de outro usuário, o sistema oferece a opção de merge de código semelhante à funcionalidade de comparação de versões.
- Todas as alterações do formulário ficam registradas em log.
✅ CORREÇÕES
- 6091 - Importação de fluxos não traz conteúdo de scripts
- 6092 - Criação de code snippet não preserva o idioma
- 6093 - Duplicação de conteúdo HML em mais de uma linha do desenho do formulário
- 6094 - Mensagem "Acess Denied" após a importação do pacote
Data de Publicação: 02/06/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 5628 - Reverter a inibição de edição de recursos JS, CSS e HTML
- 5630 - Ajuste no filtro de autenticação para priorizar cookie criado pelo Frontmanager
Data de Publicação: 21/05/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 5352 - [Ticket 16718] Minificação Low Code
- Na aba de identificação do formulário, o sistema permite que o usuário selecione o tipo de proteção de código: Nenhuma proteção (default), Minificação ou Ofuscação
- O código Javascript do Controller de cada página será alterado conforme a opção selecionada
- 5467 - Inserir comentário na gravação de versão nova do form
- Ao clicar no botão Salvar da tela de CRUD de formulário, o sistema exibe uma popup para que o usuário informe as “Notas de Release” com o que foi alterado. Se o usuário estiver gravando uma nova versão, o comentário é obrigatório
- Na tela de listagem de formulários, ao clicar no botão de ação “Log”, o sistema exibe a lista de alterações em ordem decrescente de data
- 5469 - Upload de recursos CSS, JS e HTML
- Nos CRUDs de Javascript, CSS e Página HTML, o sistema exige que o usuário selecione um arquivo para upload e não permite mais que o código seja alterado diretamente na tela
- 5468 - Associar recursos CSS, JS, HTML, Imagem e Parâmetro a projeto
- Nos CRUDs de Javascript, CSS, Página HTML, Imagem e Parâmetro, o sistema permite (opcionalmente) que o usuário selecione o projeto associado ao recurso
- A árvore do CRUD de projeto também foi alterada para contemplar os recursos vinculados ao projeto
- 5470 - Exportação de pacotes via API
- A API de automação permite a exportação de um pacote. Basta informar o nome do pacote no query param “package-name” e o sistema gera um arquivo .zip com o conteúdo do pacote
✅ CORREÇÕES
- 5531 - [Ticket - 16858] Falha ao acessar dois formulários low code simultaneamente com HTML
⚠️ OBSERVAÇÕES
Data de Publicação: 02/05/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 5003 - [Ticket 16339] - Melhoria nos logs low code
- Todos os erros que ocorrem no consumo da API Rest do Low Code ficam registrados em Log que pode ser consultado no menu Consultas -> Log de execução
- O resultado da execução de fluxos ESI, com o conteúdo das variáveis de entrada e saída e a execução de componentes assíncronos (email, por exemplo), também fica registrado no Log
- O resultado da execução de FaaS, com o conteúdo das variáveis de entrada e saída), também fica registrado no Log
- 4867 - Aceitar arquivo zipado na importação/exportação de pacotes
- A importação de pacotes aceita arquivos .zip e continua aceitando .json
- A exportação que fica na tela de detalhes do pacote oferece a opção de exportar .zip ou .json
- A exportação na tela de grid só faz exportação para .zip
Data de Publicação: 04/04/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 5002 - [Ticket 16338] - Implementar nas telas do lowcode de CSS, Javascript, HTML o mesmo recurso de "acesso público" que foi implementado em imagens
- As telas de cadastro de CSS, Javascript e HTML permitem selecionar o tipo de acesso:
- 5117 - Criar mecanismo para configurar propriedades de e-mail no componente ESI
- Foi acrescentada uma aba “Configuração” no componente de email do ESI que permite a configuração de propriedades do componente Spring JavaMailSender (ver https://www.baeldung.com/spring-email):
- 5136 - Possibilitar enviar email com anexo de ECM sem identificação do container
- Não é mais necessário informar o UUID do container ECM para identificar quais anexos serão enviados no email:
✅ CORREÇÕES
- 5004 - [Ticket - 16492] - Falha no "flowInstance.executeEsiFlow"
- 5114 - [Ticket - 16609] - Falha ao enviar e-mail com a variável nula ou vazia
🚀ORIENTAÇÕES PARA DEPLOY
- Observar as orientações descritas nas notas de release das versões anteriores
⚠️ OBSERVAÇÕES:
Data de Publicação: 15/03/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
✅ CORREÇÕES
- 4986 - Corrigir ordenação da grid de objeto de negócio
- 4987 - Revert das alterações de propriedades do pool de conexão
🚀ORIENTAÇÕES PARA DEPLOY
- Observar as orientações descritas nas notas de release da versão 1.4.2-RELEASE
⚠️ OBSERVAÇÕES:
Data de Publicação: 06/03/2024
✅ CORREÇÕES
- 4817 - Ticket 16383 - Problema no refresh do token
🚀ORIENTAÇÕES PARA DEPLOY
- ·Observar as orientações descritas nas notas de release da versão 1.4.2-RELEASE
Data de Publicação: 04/03/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 4773 - Melhoria no componente datagrid para configurar apenas visualização
✅ CORREÇÕES
- 4772 - Correção de execução de SQL de objeto de negócio qdo a coluna não existe
🚀ORIENTAÇÕES PARA DEPLOY
- Caso exista configuração para a variável APP_INTELLIGENCECENTER_BASEURL, deve ser substituída por APP_INTEGRATIONS_ INTELLIGENCECENTERURL
- Observar a configuração de variáveis descritas em Procedimentos para geração de imagem e deploy
Data de Publicação: 25/01/2024
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 4545 - Criação de mecanismo vinculado a Roles para permitir a descriptografia de informação sensível
- 4544 – Implementação da integração com MySQL para conexões de BD e API de objetos de negócio
- 4532 - Ticket - 16078 - Permitir HTML no componente de email do ESI
✅ CORREÇÕES
- 4349 - Ticket 15625 - A pesquisa avançada não traz os dados do formulário Low Code
- 4606 - Erro no carregamento da tela de merge de Código javascript
🚀ORIENTAÇÕES PARA DEPLOY
- Observar as orientações descritas nas notas de release das versões 1.2.0 e 1.3.0
- Observar a configuração de variáveis descritas em Procedimentos para geração de imagem e deploy
Data de Publicação: 29/12/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 4481 - Criar engine de integração do Low Code com o Service Management
- 4516 - Criar serviços para recuperar anexos de ticket do Service Management
- 4434 - Permitir enviar anexos de ticket no componente de email ESI
- 4535 - Permitir identificar quais anexos de ticket ou ECM serão enviados no componente de email ESI
- 4436 - Permitir enviar anexos ECM no componente de email ESI
- 4540 - Acrescentar prefixo "lowcode" nos nomes de bundle .js e .css
- 4549 - Adicionar formulário lowcode na tela de gerenciamento de liberação do Service Management
- 4550 - Atualização do jwt e do USER_LOGGED quando o Frontmanager envia um broadcast de refresh do token. Importante: caso o Low Code esteja integrado ao Service Management (ver Orientações para deploy), o USER_LOGGED terá todos os atributos do USER_LOGGED do Centro de Experiência do Service Management
✅ CORREÇÕES
🚀ORIENTAÇÕES PARA DEPLOY
- Após a implantação dessa versão, devem ser reiniciados todos os Pods do ITSM (Service Management). Caso contrário, as telas do Service Management que dependem do Low Code não vão funcionar.
- Para funcionar o envio de email com anexos implementado nos cards 4434 e 4435, devem ser observadas as mesmas instruções descritas nas notas de release da versão 1.1.3:
- Deve ser acrescentada a variável APP_INTEGRATIONS_FRONTMANAGERURL no ConfigMap do Low Code, apontando para a URL de backend do Frontmanager. Exemplo: APP_INTEGRATIONS_FRONTMANAGERURL: http://hyper-frontmanager-api
- Deve ser implantada a versão 2.5.0 ou superior do frontmanager-api, que contenha o endpoint que detalha a caixa postal de email: GET internal/email-boxes/{uuid}
- Para funcionar a integração do Low Code com o Service Management implementada no card 4481 e o envio de email com anexos de ticket implementado no card 4434:
- Deve ser acrescentada a variável APP_INTEGRATIONS_SERVICEMANAGEMENTURL no ConfigMap do Low Code, apontando para a URL de backend do Service Management. Exemplo: APP_INTEGRATIONS_ SERVICEMANAGEMENTURL: http://itsm.frontmanager-dev-eveo/4biz
Data de Publicação: 29/12/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 4276 - Implementar integração com banco de dados DB2
- 4285 - Implementar controle de acesso no cadastro de conexões de BD
- 4324 - Refactory no log de execução ESI, no padrão do log FaaS
- 4429 - Permitir envio de anexos de container ECM
- 4446 - Permitir merge de código javascript de formulários
✅ CORREÇÕES
- 4296 - Erro na identificação de parâmetros do tipo array na API do objeto de negócio
🚀ORIENTAÇÕES PARA DEPLOY
- Para funcionar o envio de email corrigido no card #4429, devem ser observadas as mesmas instruções descritas nas notas de release da versão 1.1.3:
- Deve ser acrescentada a variável APP_INTEGRATIONS_FRONTMANAGERURL no ConfigMap do Low Code, apontando para a URL de backend do Frontmanager. Exemplo: APP_INTEGRATIONS_FRONTMANAGERURL: http://hyper-frontmanager-api
- Deve ser implantada a versão 2.5.0 ou superior do frontmanager-api, que contenha o endpoint que detalha a caixa postal de email: GET internal/email-boxes/{uuid}
Data de Publicação: 28/11/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 3681 - Criação de log para execução de FaaS
- 3682 - Criação de endpoint para listagem paginada de objetos de negócio e utilização na diretiva de grid o /data/{project}/{business-object}/paged
✅ CORREÇÕES
- 4021 - Componente Email ESI não envia anexo (Ticket 15680)
🚀ORIENTAÇÕES PARA DEPLOY
- Para funcionar o envio de email corrigido no card #4021:
- Deve ser acrescentada a variável APP_INTEGRATIONS_FRONTMANAGERURL no ConfigMap do Low Code, apontando para a URL de backend do Frontmanager. Exemplo: APP_INTEGRATIONS_FRONTMANAGERURL: http://hyper-frontmanager-api
- Deve ser implantada a versão 2.5.0 ou superior do frontmanager-api, que contenha o endpoint que detalha a caixa postal de email: GET internal/email-boxes/{uuid} ·
- Para que o Low Code SDK consuma o serviço /data/{project}/{business-object}/paged implementado no card 3682, deve ser implantada a versão 1.0.2 do FaaS
Data de Publicação: 08/11/2023
✅ CORREÇÕES
- 3887 - Correção da importação de fluxos ESI
- 3963 - Inibição da atualização do token até resolver problema de refresh de telas
Data de Publicação: 22/10/2023
✅ CORREÇÕES
- 3689 - Correção da integração com Service Management acarretada pela minificação de recursos. Algumas funcionalidades do Service Management que dependem de integração com o Low Code deixaram de funcionar na versão 1.1.0-RELEASE. Por exemplo: flowDesign
Data de Publicação: 10/10/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 3580 - Minificação de recursos javascript e css
- 3584 - Criação de componentes ESI para criptografia de informações
- 3585 - Criação de atributo com informações sensíveis no objeto de negócio
- 3586 - Criação de componente de formulário para criptografia de informações
✅ CORREÇÕES
- 3629 - Correção da exclusão de tabs de formulários Low Code
- 3593 - Correção do componente de formulário input.identifier
- 3666 – Correção dos atributos de acesso público na importação de pacote
Data de Publicação: 29/09/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 3561 – Criação de mecanismo para compartilhamento de recursos MinIO entre dois tenants
- 3576 - Solução de deadlock na execução de script de BD
- 3572 - Criação de botão para executar DDL de índice no objeto de negócio
- 3573 – Aumento do limite de tamanho de upload de arquivo na importação de pacotes
- 3575 - Simplificação de imagem Docker do Low Code para diminuir tamanho
✅ CORREÇÕES
- 4817 - Ticket 16383 - Problema no refresh do token
🚀ORIENTAÇÕES PARA DEPLOY
- Criar novo Tenant B seguindo os procedimentos normais.
- Configurar nova variável no config map do Low Code: APP_RESOURCE_ENABLEALTERNATIVEKEY: true
- Configurar propriedades TENANTS_CONFIGS_X_DATASOURCE ou Resource Tenant DATABASE para o novo Tenant B, apontando as configurações de Banco de Dados para as mesmas configurações do Tenant A.
- Configurar propriedades TENANTS_CONFIGS_X_OBJECTSTORAGE ou Resource Tenant OBJECT_STORAGE para o novo Tenant A, apontando as configurações de MinIO para as mesmas configurações do Tenant B.
- Criar propriedade TENANTS_CONFIGS_X_OBJECTSTORAGE_PREFIXKEY ou setar a propriedade prefixKey do Resource Tenant OBJECT STORAGE para o novo Tenant A com o valor do TENANTS_CONFIGS_Y_ID do Tenant B.
- Copiar as configurações DYNAMICCONNECTIONS_CONFIGS_X ou copiar as configurações do Resource Tenant LOWCODE CONNECTIONS do Tenant A para o novo do Tenant B, só alterando o DYNAMICCONNECTIONS_CONFIGS_X_TENANT para o id Tenant A.
Data de Publicação: 21/09/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 3377 - Acrescentar FaaS.Console na saída do endpoint integrations/{name}/faas
- 3388 - Atributo _search em conflito com o atributo _filter na API data do Low Code
- 3393 - Refactory na parametrização da URL da IDE e Renderer do Mobile no Low Code
✅ CORREÇÕES
- 3387 - Correção da duplicação de Schema e Screen na IDE Mobile
🚀ORIENTAÇÕES PARA DEPLOY
- Para que a segregação de ambiente da IDE de construção de aplicativos Mobile implementada no card 3393 funcione corretamente, é necessário que seja retirado o host das URLs das variáveis de ambiente que foram configuradas com base em orientação do último release notes da vesão 1.0.0-RELEASE:
- APP_MOBILE_IDEURL: aponta para o contexto da URL do Low Code Mobile IDE, cujo padrão é /hyper-lowcode-ide
- APP_MOBILE_RENDERERURL: aponta para contexto da URL de renderização do Low Code Mobile , cujo padrão é /hyper-lowcode-renderer
Data de Publicação: 31/08/2023
🆕 MELHORIAS / NOVAS FUNCIONALIDADES
- 2802 - Desenvolvimento de solução de testes integrados no Low Code
- 2665 - Criação de novos componentes Low Code para IA:
- AITextClassification
- AIPredictDataByModelTF
- AIPredictDataByModelSKLearn
- AIPredictDataByModelCode
- 3362 - Criação de novos componentes de fluxo ESI
- AIOCR
- MSTeams
- Discord
- GenerativeAIOpenAI
- SlackSendMessage
- Kafka
- FileToBase64
- ApacheVelocity
- 3209 – Criação serviço REST Low Code para importação de pacotes
- Criação de endpoint POST /automations/${tenant_id}/packages para importação de pacotes
- Criação de endpoint GET /automations/${tenant_id}/packages/${uuid}/logs para obtenção do log de importação de pacotes
- 3179 - Refactory das propriedades dos componentes da IDE (definitions)
- 2643 - Adequação do backend e fluxo ESI de geração do build Mobile para usar Expo
- 3314 - Refactory dos parâmetros do Build Mobile
- 3317 – Segregação dos ambientes de IDE e renderização do Mobile
- 3313 - Alteração do tipo das colunas timestamp para resolver timezone e reestruturação das propriedades do Build
✅ CORREÇÕES
- 3313 - Correção da duplicidade de aplicações Mobile no frontend do Low Code
- 3372 - Correção de problema na propagação de exceção do tipo BD na execução de fluxos ESI
- 3375 - Correção da exibição de ícones em abas de formulários Low Code
🚀ORIENTAÇÕES PARA DEPLOY
- Para o correto funcionamento dos novos componentes de IA implementados no card 2665, é necessário que seja configurada a variável de ambiente APP_INTELLIGENCECENTER_BASEURL apontando para a URL base do Intelligence Center (exemplo: https://icenter-dev-eveo.cloud4biz.com)
- Para que a segregação de ambiente da IDE de construção de aplicativos Mobile implementada no card 3317 funcione corretamente, é necessário que sejam configuradas a variáveis de ambiente:
- APP_MOBILE_IDEURL: aponta para a URL do Low Code Mobile IDE (exemplo: https://admin-dev-eveo.cloud4biz.com/hyper-lowcode-ide)
- APP_MOBILE_RENDERERURL: aponta para a URL de renderização do Low Code Mobile Web (exemplo: https://admin-dev-eveo.cloud4biz.com/hyper-lowcode-renderer)